Antes de entrar en el fondo de estas dos integraciones, conviene recordar de dónde nace MediLog. En un artículo dedicado a la comparación entre FSE y PHR expliqué por qué un PHR (Personal Health Record, historia clínica personal) es una herramienta radicalmente distinta de un FSE (Fascicolo Sanitario Elettronico, el expediente sanitario electrónico público italiano): el primero está pensado en torno al paciente, que lo controla y decide qué contiene y quién puede verlo; el segundo está pensado en torno al servicio sanitario que lo presta, y el paciente es más su destinatario que su propietario.
MediLog (contado aquí) es el PHR que construí a partir precisamente de esa idea: una historia clínica que no pertenece a ningún centro concreto, sino al propio paciente: informes, documentos, imágenes DICOM, observaciones, datos de wearables, todo en un único sitio, con independencia de qué médico, hospital o centro lo haya generado. Lo construí ante todo para un uso personal y familiar: gestionar mi historial clínico y el de quienes me rodean, sin tener que perseguir más informes dispersos entre portales distintos, cada uno con sus credenciales y su interfaz. Las dos historias contadas en este artículo, Garmin y DICOM, nacieron ambas de esa misma necesidad, muy concreta.
La obtención de datos de Garmin fallaba en producción porque Cloudflare bloquea la IP del datacenter de OCI en cualquier estrategia de inicio de sesión, no por un fallo: resuelto trasladando el inicio de sesión a una app local y haciendo transitar el dato por un staging temporal en MinIO. La videodermatoscopia Canfield DermaGraphix, encerrada en un formato propietario sin función de exportación, se extrajo mediante automatización de la interfaz y se reconvirtió en un estudio DICOM estándar con dicom_manager, importado en Orthanc como un examen cualquiera.
Un SmartWatch que lo registra todo y un servicio en la nube que no deja salir nada.
MediLog se concibió para poder contener también datos procedentes de dispositivos médicos o deportivos wearable. Un SmartWatch permite registrar datos como la frecuencia cardíaca continua o la SpO2 (saturación), almacenados durante la actividad física y en reposo: información que para muchos pacientes ya existe, recogida a diario por un reloj deportivo, y que se queda encerrada dentro de la app del fabricante en lugar de acabar junto al resto de la historia clínica.
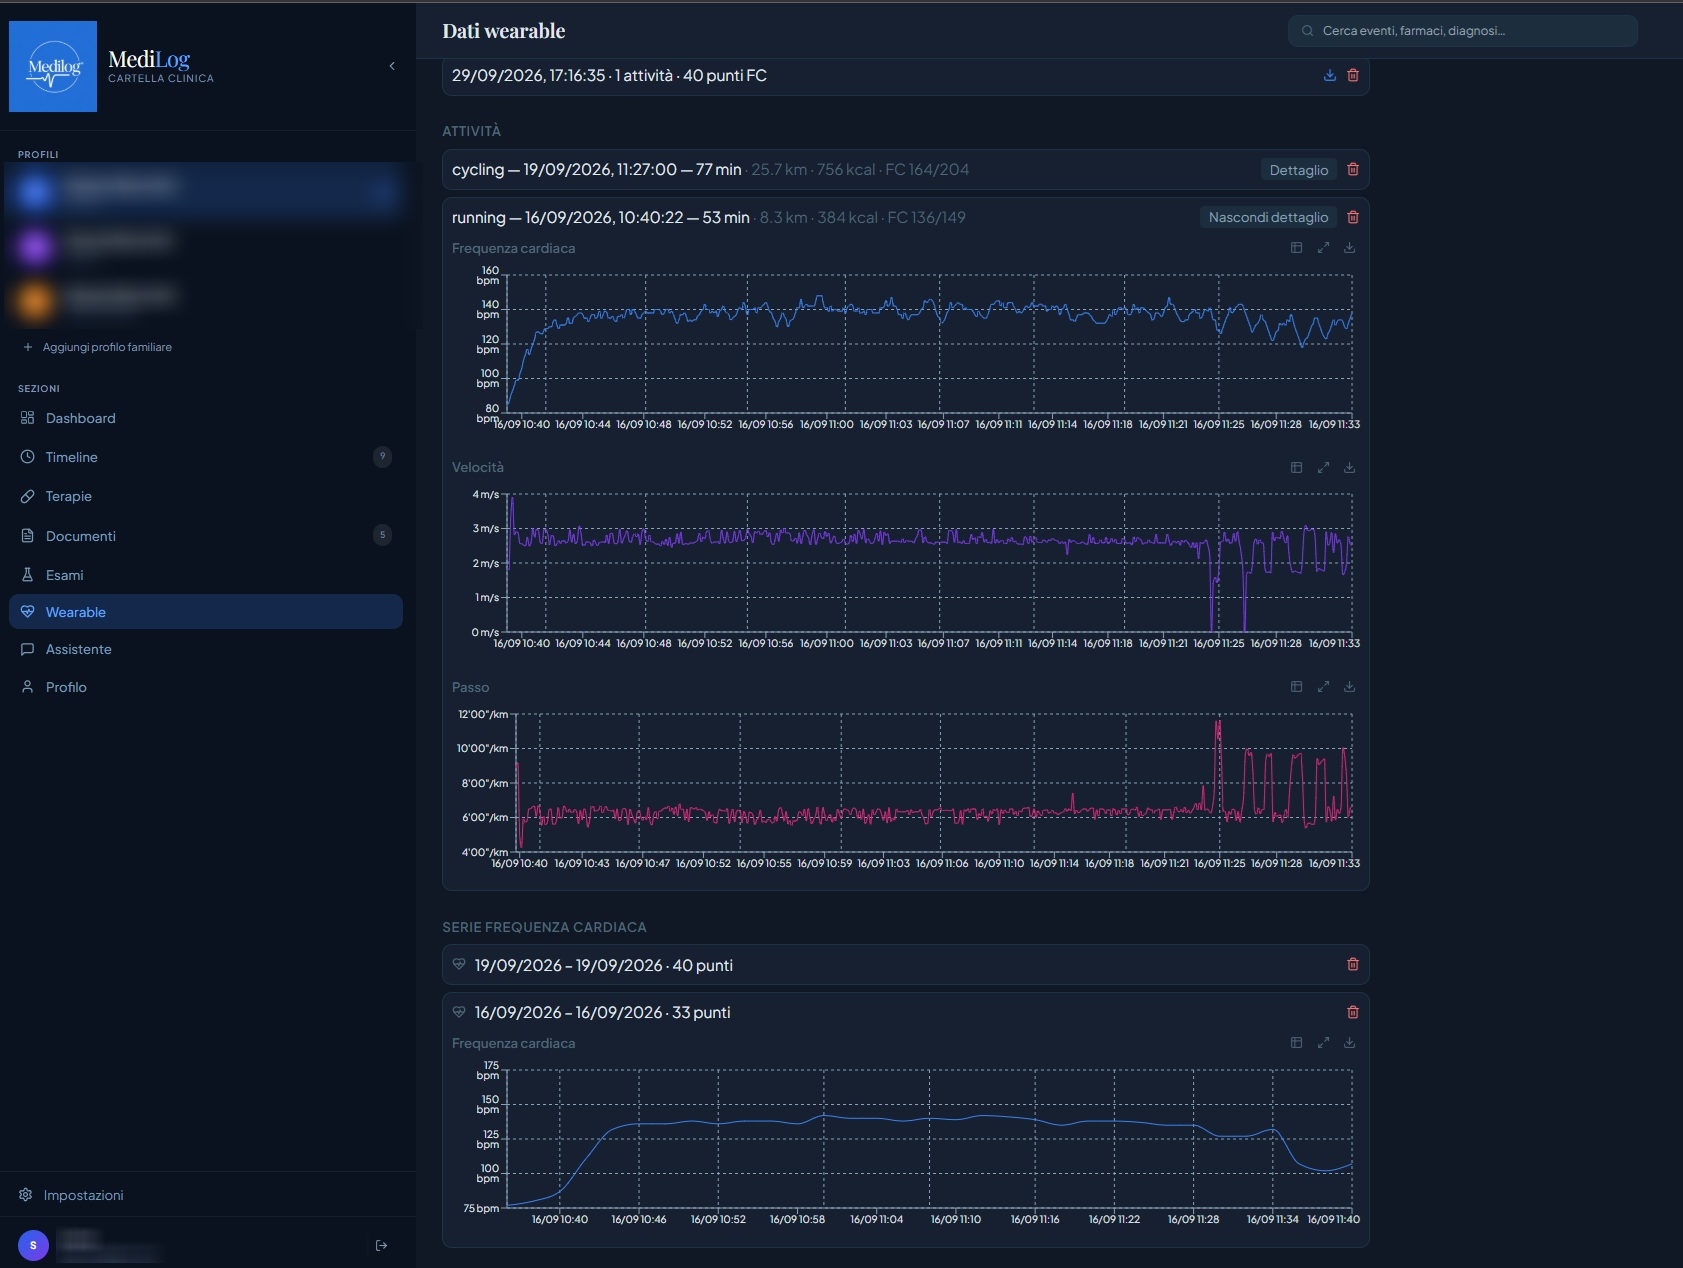
Para un usuario de Garmin, el objetivo era sencillo de enunciar: recuperar actividades y frecuencia cardíaca de Garmin Connect y guardarlas entre los datos del paciente en MediLog con el mismo esquema «vista previa → confirmación» ya usado para los informes de laboratorio. Ninguna credencial de Garmin guardada en ningún sitio, y el fetch (la recuperación de datos del servicio externo — en este caso Garmin Connect, llamado a petición para ir a buscar actividades y frecuencia cardíaca) siempre a petición explícita, nunca automático.
Cloudflare es un servicio que se interpone entre el tráfico de internet y el servidor real de un sitio o de una app: cada petición pasa primero por sus datacenters, que la filtran, y solo si la consideran legítima la dejan seguir hacia el servidor real del fabricante. Nace como protección frente a los ataques (absorber oleadas de tráfico malicioso antes de que arrollen al servidor de origen) y como red de distribución de contenidos, pero la función que aquí importa de verdad es la tercera: la detección automática de bots (programas que se conectan a un sitio o a un servicio en lugar de una persona, a menudo en cantidad y a una velocidad que un ser humano jamás podría alcanzar) y de scraping (el uso de uno de esos programas para extraer datos en masa de un sitio o de un servicio, normalmente sin que el propietario lo haya autorizado). El filtro analiza cada petición — huella TLS del cliente, comportamiento, reputación de la dirección IP de origen — antes incluso de que llegue a la aplicación, intentando distinguir un programa automático de una persona real.
Es un servicio muy utilizado — una parte enorme del tráfico mundial pasa por sus datacenters — precisamente porque proteger un inicio de sesión de los intentos automáticos de robo de credenciales («credential stuffing») o del scraping masivo es un problema común a cualquier servicio con una base de usuarios amplia, Garmin incluido: nuestro fetch, aunque legítimo, se parece desde fuera exactamente al tipo de tráfico automatizado que estos filtros están pensados para bloquear.
El muro: la IP del datacenter ya está marcada
El primer despliegue en producción del fetch directo — mediante la librería no oficial garminconnect, que replica el inicio de sesión web/móvil de la app Garmin Connect — fracasó sistemáticamente. No con un error de autenticación: con un rechazo previo, antes incluso de que las credenciales importaran, señalado por el propio protocolo HTTP con los códigos 429 («demasiadas peticiones», el servidor pide explícitamente que se vaya más despacio o deja de responder del todo) y 403 («acceso denegado», la petición se reconoce y se bloquea sin más). No eran errores de aplicación nuestros: eran respuestas de bajo nivel, antes incluso de que la petición llegara de verdad a Garmin.
Las cinco estrategias de inicio de sesión probadas (combinaciones de endpoints móvil/widget/portal y de librería HTTP subyacente) fueron rechazadas del mismo modo, con las mismas credenciales que funcionan sin problemas desde un navegador normal. No era un fallo que se pudiera resolver a base de reintentos: el problema era la reputación de la dirección IP de nuestro servidor, no el código.
El mismo patrón exacto — handshake de aplicación rechazado enseguida, reproducible con credenciales distintas, no un límite de tasa temporal sino una marca sobre la propia dirección — ya nos había ocurrido meses antes con el agente de WhatsApp, que nunca se desbloqueó y que finalmente se retiró de la plataforma. La hipótesis más probable en ambos casos: Cloudflare trata a priori los rangos de IP de los grandes datacenters cloud como fuentes de tráfico automatizado, con independencia de lo que esté ocurriendo realmente detrás de esa petición.
Nuestro servidor funciona en Oracle Cloud Infrastructure: no hemos verificado (todavía) empíricamente si saltaría el mismo bloqueo partiendo de Azure, GCP o AWS, pero el mecanismo descrito no tiene nada específico de OCI, y la cautela sugiere considerarlo un riesgo estructural de cualquier IP con reputación de «datacenter», no una particularidad de nuestro proveedor.
La solución alternativa: trasladar el fetch, no el dato
La vía limpia para acceder a los datos del servicio sería adherirse al Garmin Connect Developer Program oficial, pero todos los intentos que hice para entrar en el programa no obtuvieron respuesta, y varias búsquedas en la red recogen la misma experiencia de otros desarrolladores. Mientras tanto hacía falta algo que funcionara enseguida, sin perder el self-service: tiene que ser el propio usuario (o un familiar) quien pueda recuperar sus datos, no una intervención manual nuestra cada vez.
La solución adoptada separa desde dónde se habla con Garmin de dónde vive el dato final:
Una pequeña app Next.js independiente, pensada para funcionar en local en un PC o en una red doméstica (IP que no es de datacenter, nunca bloqueada), autenticada con la misma cuenta de Clerk de producción. El usuario inicia sesión con sus credenciales de Garmin solo desde ahí; el fetch recupera actividades, frecuencia cardíaca y, a petición por cada actividad, el detalle fino (frecuencia cardíaca, altitud y velocidad punto por punto, no solo el resumen diario).
Staging, es decir, un área de paso temporal, no el destino final del dato: el resultado (un archivo JSON) se sube, con un token del usuario conectado, a un bucket MinIO dedicado en producción — ningún endpoint de Garmin se llama nunca desde el servidor de producción. MinIO es el servicio de almacenamiento de objetos de código abierto (compatible con las mismas API de Amazon S3) que ya usamos para guardar documentos y adjuntos; aquí, sin embargo, hace solo de almacén intermedio, no de depósito permanente de los datos. De hecho, los archivos caducan solos a los 7 días, precisamente porque esta área no está pensada para conservar nada a largo plazo, solo para hacerlo transitar hacia la importación propiamente dicha.
Dentro de MediLog, una nueva sección enumera los archivos en staging del usuario y reutiliza exactamente el mismo componente de vista previa y el mismo endpoint de guardado ya existentes para los informes de laboratorio — ninguna lógica de importación duplicada.
Fetch directo desde el servidor
- Inicio de sesión de Garmin ejecutado desde la IP del datacenter de OCI
- Bloqueado en todas las estrategias probadas (429 / 403)
- Ningún dato recuperable en producción, nunca
Fetch local + staging en MinIO
- Inicio de sesión de Garmin ejecutado desde una IP residencial/de desarrollo, nunca bloqueada
- La misma UX de self-service, con un paso más
- Credenciales de Garmin que el servidor de producción nunca ve
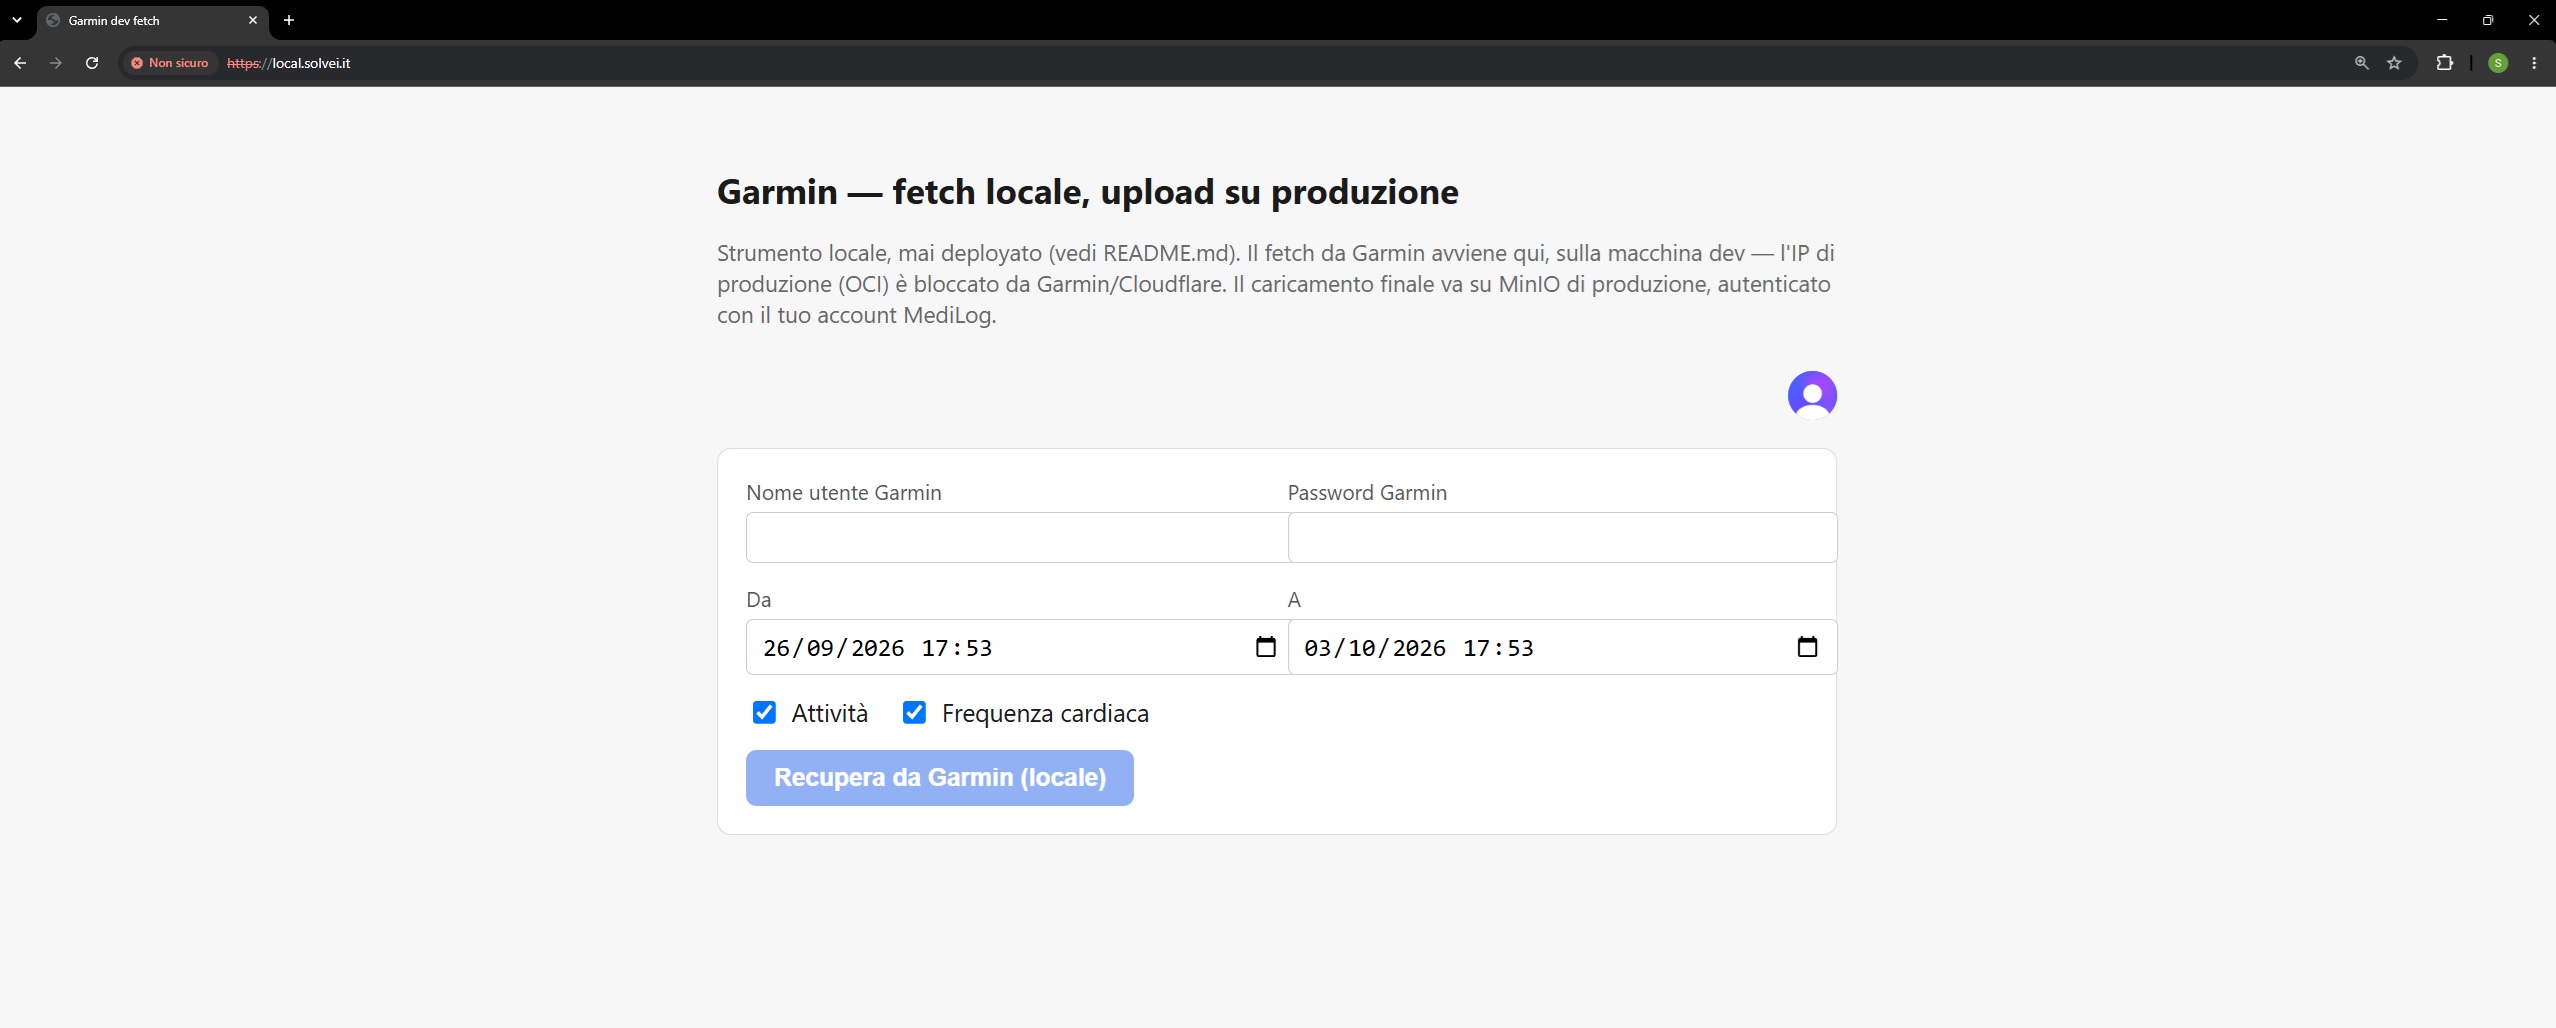
Los datos de wearables importados aparecen hoy también en la línea de tiempo clínica del paciente, intercalados con los eventos reales (no solo en su pestaña dedicada) con un color distinto, de modo que una actividad deportiva o una sesión de frecuencia cardíaca puedan leerse en el contexto de todo lo demás — una visita, un informe, un documento cargado en el mismo periodo.
Importar a MediLog una videodermatoscopia nacida para quedarse cerrada
El segundo problema es distinto en la forma pero idéntico en el fondo: un dato clínico que existe de verdad, que ya está en el disco del paciente, pero que está prisionero de un formato y de una aplicación que no prevén ninguna salida estándar. Antes de contar el caso concreto, sin embargo, conviene entender qué es realmente el DICOM y por qué es precisamente ese estándar, y no un formato de imagen cualquiera, el que marca la diferencia.
Qué es realmente un archivo DICOM
DICOM (Digital Imaging and Communications in Medicine) es el estándar internacional — en uso desde 1993, mantenido por la asociación estadounidense NEMA — con el que prácticamente todo equipo de diagnóstico por imagen médico produce y exporta sus datos: TAC, resonancia magnética, ecógrafo, mamógrafo y, como en el caso de este artículo, también una cámara clínica. No es «un formato de imagen» en el sentido de JPEG o PNG: es un contenedor que une de forma indisoluble los píxeles a un bloque de metadatos clínicos estructurados — quién es el paciente, a qué examen pertenece la imagen, a qué serie dentro de ese examen, con qué equipo y con qué parámetros se adquirió, cuándo. El archivo sabe por sí solo a quién y a qué pertenece, sin necesidad de una base de datos externa que lleve la contabilidad en su lugar.
Una foto JPEG es una isla: para saber de quién es, a qué visita pertenece, si forma parte de una serie de otras imágenes relacionadas, siempre hace falta un sistema externo que lo recuerde en su lugar. Un archivo DICOM lleva consigo esta información — paciente, estudio, serie, instancia, fecha de la visita (y también otros datos). No es un detalle técnico para iniciados: es la diferencia entre un dato que puede viajar solo hacia cualquier sistema conforme al estándar y uno que se queda prisionero de la base de datos (o del software) que lo generó.
Además del contenedor, DICOM define también un protocolo de red para el intercambio entre sistemas distintos: enviar un estudio a un archivo, consultarlo, recuperarlo desde un visor. El archivo se llama PACS (Picture Archiving and Communication System) — el sistema que, en cualquier servicio de radiología o historia clínica digital como MediLog, conserva de forma centralizada todos los estudios de diagnóstico por imagen y los pone a disposición de los visores que deben mostrarlos (en MediLog es Orthanc). Es el mismo lenguaje que permite que una TAC hecha en un hospital se abra, se lea y se mida en otro, con un software de un fabricante completamente distinto del que hizo la adquisición. La interoperabilidad no es un opcional del estándar: es la razón por la que existe.
JPEG, PNG, un archivo de imagen cualquiera
- Ningún vínculo nativo con el paciente, el examen o la serie
- Siempre hace falta una base de datos externa para dar contexto clínico
- Cada fabricante organiza sus archivos a su manera
- Portabilidad cero entre sistemas/software distintos
DICOM
- Paciente, estudio, serie e instancia dentro del propio archivo
- Legible por cualquier visor conforme al estándar
- El mismo lenguaje usado por TAC, RM y ecógrafos de todos los fabricantes
- Pensado explícitamente para moverse entre PACS distintos
Un examen en formato DICOM sigue siendo legible dentro de diez años, con un software distinto del que lo adquirió, en un centro distinto del que lo produjo — una segunda opinión, un cambio de médico, un traslado de cuidados no requieren «convertir» nada. Un examen encerrado en el formato propietario de un único fabricante, en cambio, deja de ser realmente utilizable en el momento en que ese software concreto ya no está disponible, actualizado o sencillamente a mano — exactamente la situación descrita en el resto de esta sección.
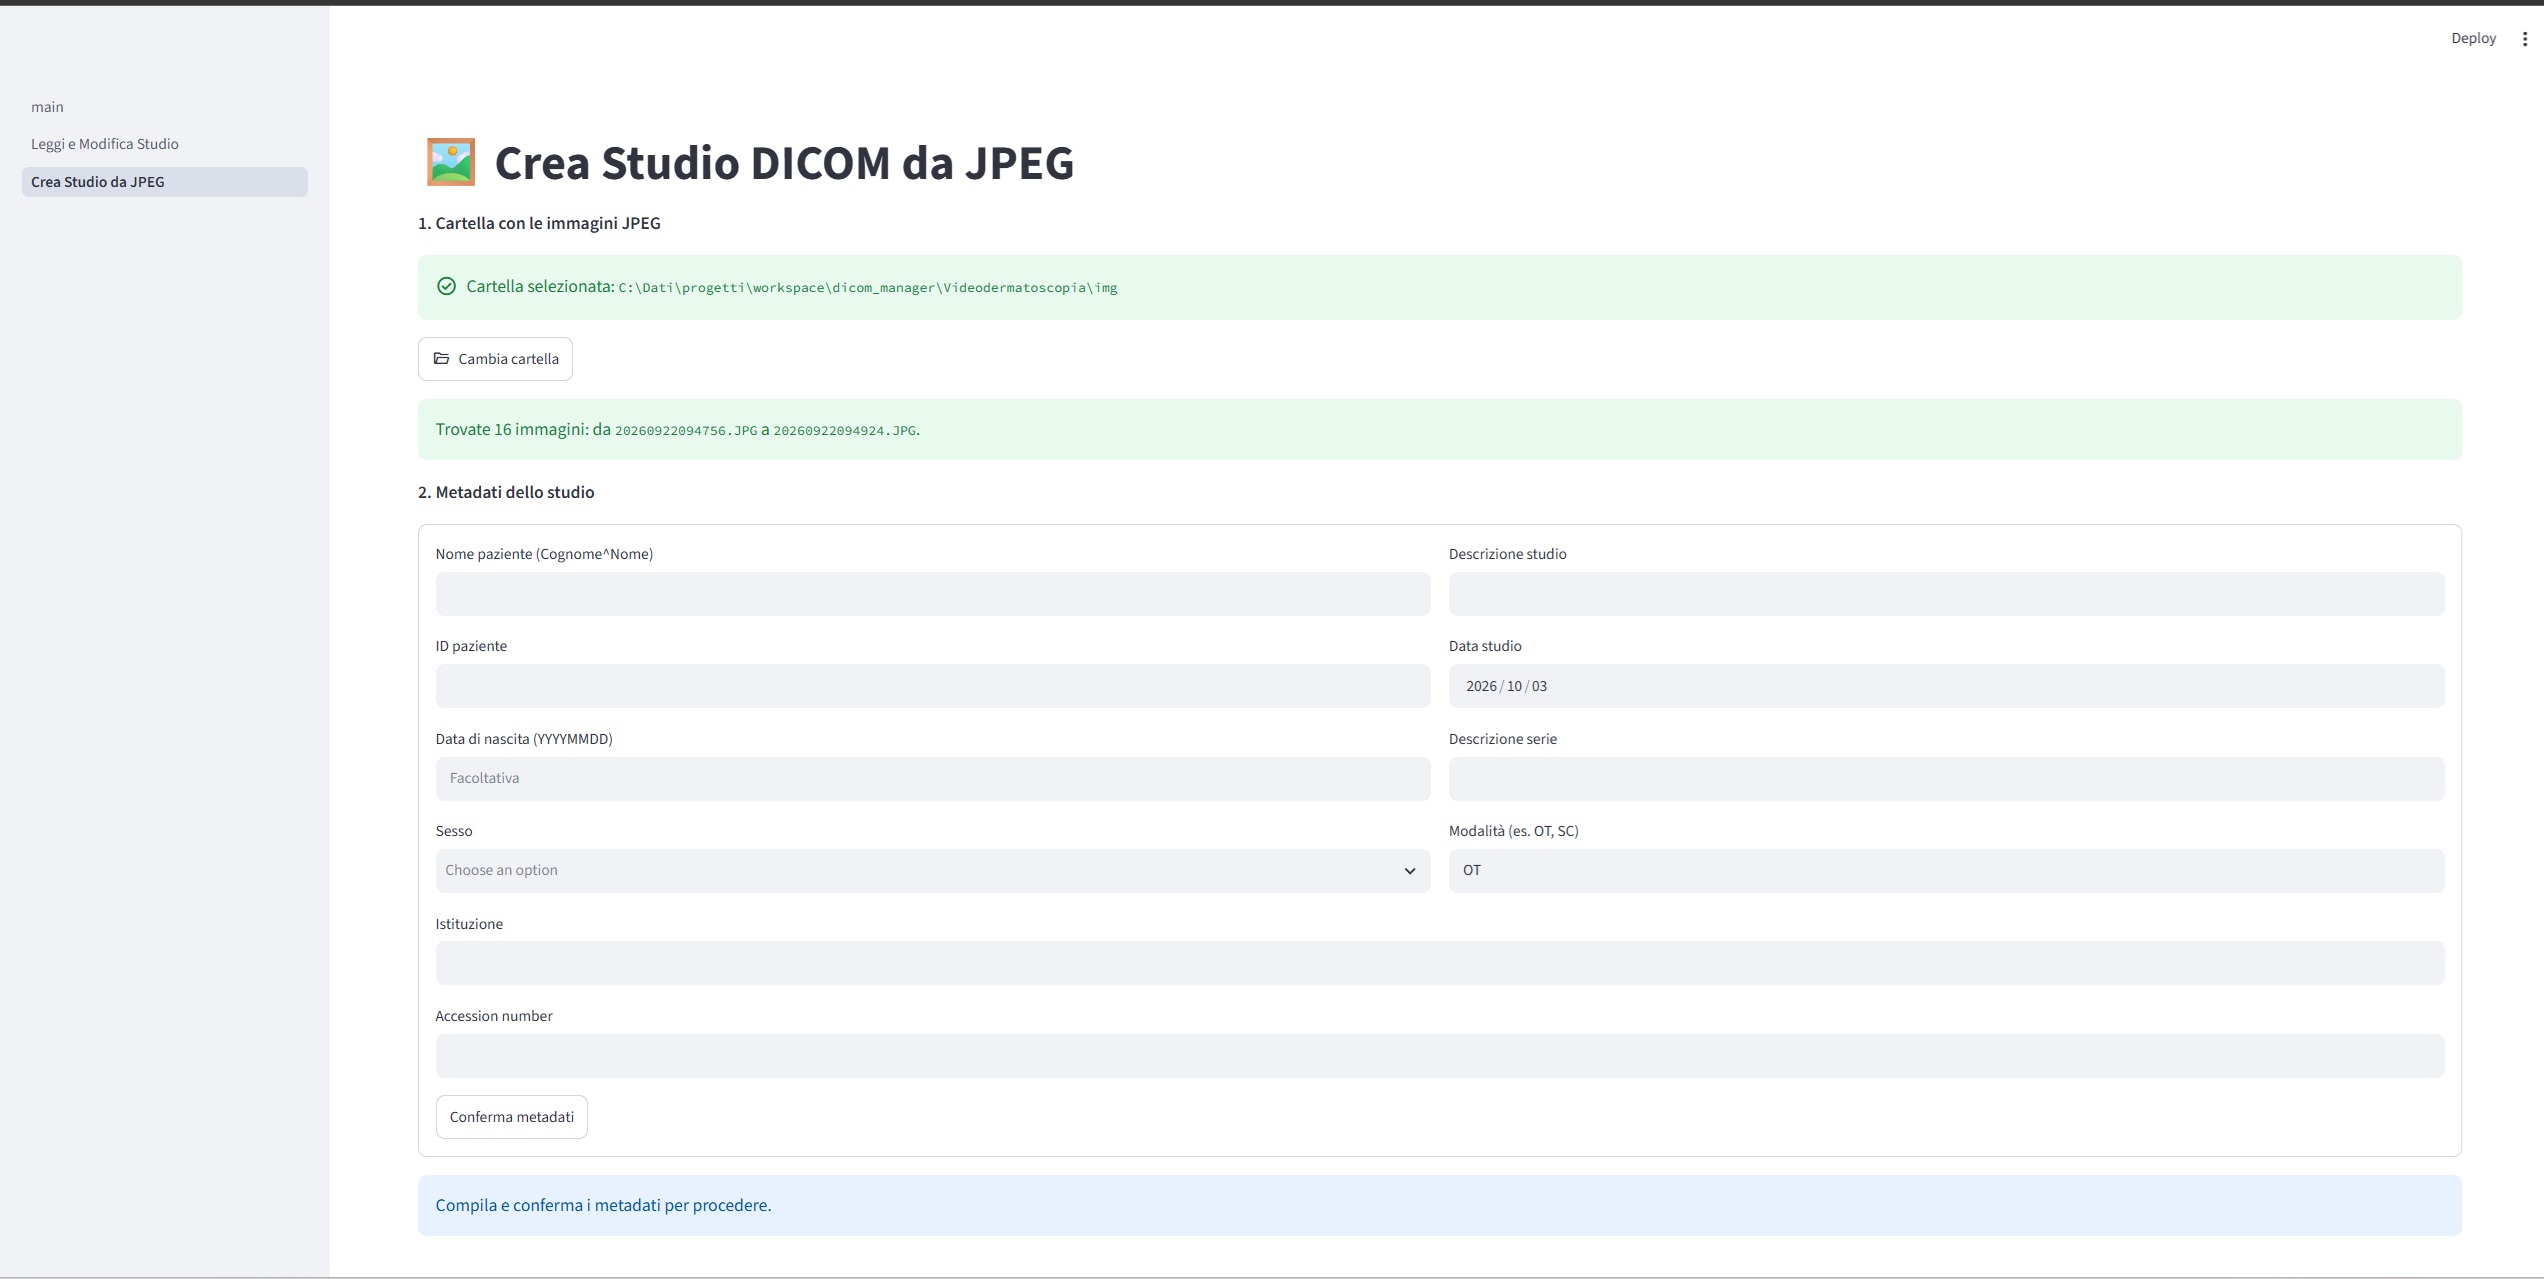
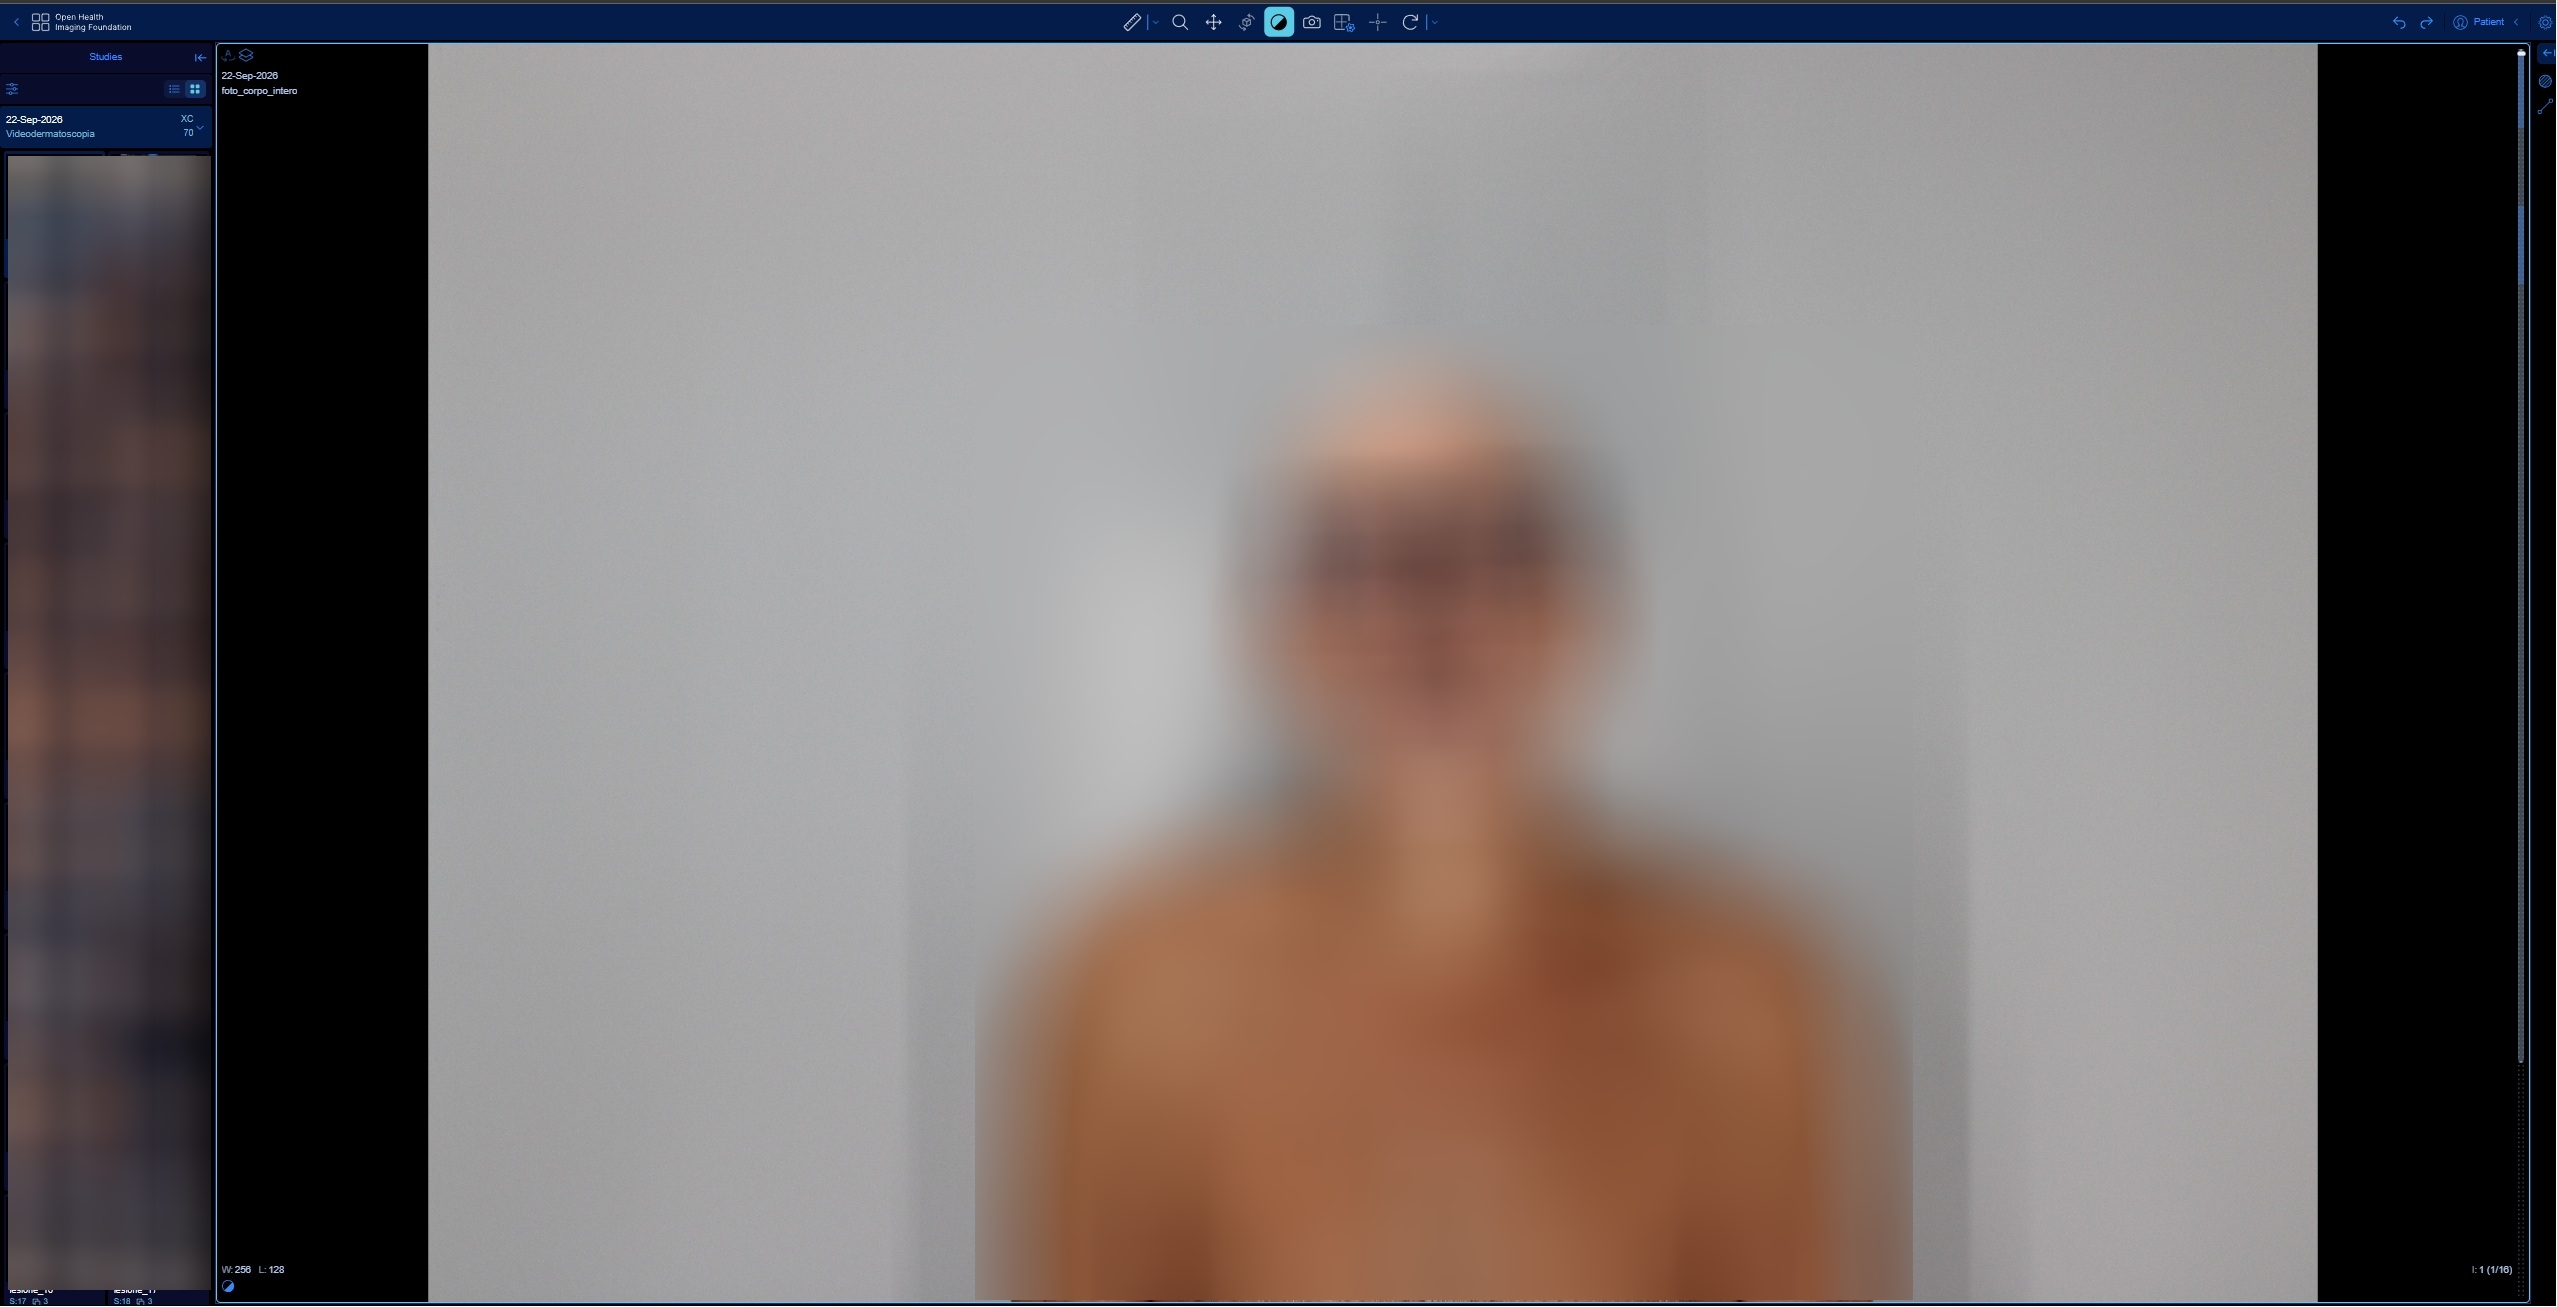
MediLog usa Orthanc como PACS para los estudios DICOM y OHIF como visor integrado. Orthanc es un servidor PACS de código abierto, ligero y pensado precisamente para autoalojarse: recibe, archiva y sirve los estudios DICOM de todos los pacientes, exponiendo las API estándar (query/retrieve) que cualquier visor conforme sabe consultar — es el almacén central en el que acaba apoyándose cada examen, sea cual sea su origen. OHIF (Open Health Imaging Foundation) es en cambio el visor: el programa, también de código abierto y basado en web, con el que el estudio archivado en Orthanc se muestra y se navega de verdad — zoom, desplazamiento entre las imágenes de una serie, mediciones — integrado directamente en la página de MediLog en lugar de ser una aplicación aparte que haya que abrir. Para meter cualquier cosa que no sea ya DICOM nativo (fotos clínicas, informes escaneados como imágenes, adquisiciones de equipos que solo hablan su propio formato propietario) construimos una herramienta dedicada, dicom_manager: una app Streamlit independiente que lee, visualiza, modifica y sobre todo crea estudios DICOM a partir de simples imágenes JPEG, con un flujo de guardado de varios pasos pensado expresamente para no tocar nunca los originales.
El caso concreto: la videodermatoscopia encerrada en DermaGraphix
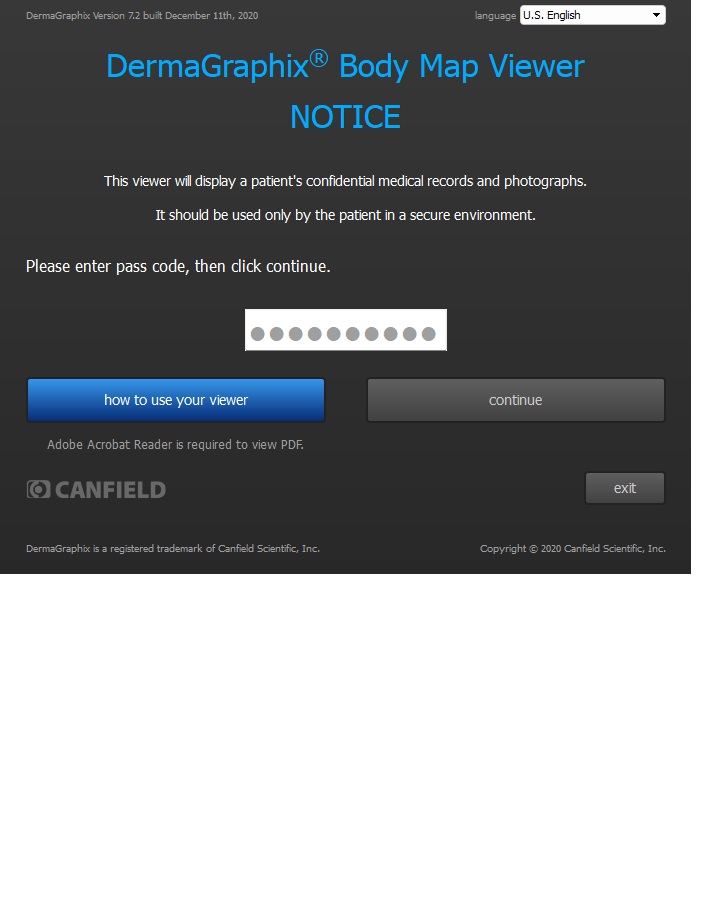
El centro dermatológico que realiza el mole-mapping (total-body photography + dermatoscopia cercana de las lesiones que hay que vigilar en el tiempo) no suele entregar las imágenes: como mucho, a petición explícita del paciente, facilita una copia portátil del software del fabricante — Canfield DermaGraphix (nombre comercial de la plataforma VECTRA) — con la que volver a verlas, protegida por una contraseña personal. Ningún botón «exportar» en ninguna parte de la interfaz.
Dentro de la carpeta del paciente: una cámara réflex estándar produce 16 fotos de cuerpo entero en JPEG normalísimo, legible por cualquiera. Pero el algoritmo de detección automática de lesiones guarda más de mil candidatas por foto dentro de archivos JSON (con los recortes incrustados en base64), las lesiones confirmadas clínicamente viven en una base de datos SQLite aparte, y las imágenes dermatoscópicas propiamente dichas — las adquiridas con la sonda de cerca — se guardan en un contenedor binario propietario (.t2k) sin ninguna firma JPEG o PNG reconocible: ilegible con cualquier herramienta estándar.
Tres formatos distintos, ninguno de los cuales expone una imagen que se pueda abrir directamente — salvo, precisamente, dentro del propio software. La única forma de ver de verdad una dermatoscopia era hacer que el visualizador la renderizara y capturarla desde ahí.
Consultar la base de datos, no adivinarla
Antes de llegar al screen-scraping, sin embargo, hacía falta entender qué imágenes capturar. El software muestra solo las lesiones confirmadas por el dermatólogo — un número mucho menor que los miles de candidatas algorítmicas en bruto. Consultando directamente la base de datos SQLite del software (con el módulo nativo node:sqlite de Node.js, en solo lectura) apareció el esquema real: una tabla LESION con las lesiones clínicas seguidas, una tabla de enlace LESION_IMAGE que vincula cada lesión con su foto de contexto de cuerpo entero y, cuando existe, con su adquisición dermatoscópica dedicada.
Esto permitió saber de antemano, sin abrir nada a ojo, exactamente qué lesiones tenían de verdad una imagen dermatoscópica asociada y cuáles no — ahorrando ciclos de captura inútiles y haciendo que la verificación final fuera un control puntual, no una búsqueda a ciegas.
Cuando la única API es la interfaz gráfica
Sin ninguna función de exportación, la extracción de las imágenes dermatoscópicas se convirtió en automatización de la interfaz: un asistente de IA manejó directamente la aplicación de Windows — activando la ventana correcta, introduciendo el número de cada lesión en el campo de búsqueda, esperando la carga de la imagen y capturando la pantalla — una vez por cada lesión clínicamente seguida, verificando cada captura comparando en pantalla el número esperado con la etiqueta que el software mostraba realmente.
No un script que «lee» un archivo: una secuencia de clics y teclas simuladas, con todas las dificultades típicas de la automatización de GUI — el foco que se escapa hacia el terminal en lugar de quedarse en la ventana de la app, el nombre del proceso que cambia tras el inicio de sesión, un campo de búsqueda que a veces «arranca» antes de que termine la escritura. Cada contratiempo resuelto con la espera explícita o la verificación adecuada, no con un timeout más largo puesto al azar.
Todo el proceso se realizó en el disco externo del paciente, con las credenciales del visualizador facilitadas por el propio paciente, sin que un solo byte saliera de esa máquina hacia servicios externos.
De las imágenes extraídas a un estudio DICOM de verdad
Con las imágenes por fin en la mano como archivos JPEG normales, entró en juego dicom_manager: no su interfaz Streamlit, sino la librería subyacente (dicom_lib/convert.py), invocada desde un script dedicado escrito para la ocasión. El estudio generado reproduce fielmente la estructura clínica de la sesión:
- una serie con las fotos de cuerpo entero, en el orden en que se tomaron;
- por cada lesión seguida, una serie propia con el recorte de contexto, la captura de pantalla de la ubicación en el cuerpo y, cuando está disponible, la imagen dermatoscópica de cerca;
- un único
StudyInstanceUIDcompartido, de modo que todas las series permanezcan agrupadas como un solo examen en el visor.
Los JPEG originales se incrustan tal cual, sin recodificar: la misma calidad que el original, a una fracción del espacio de un DICOM sin comprimir (el estudio de ejemplo pasa de unos 1,3 GB a unos 126 MB). La modalidad asignada es XC — fotografía con cámara externa — la más adecuada para fotos clínicas y dermatoscopia que no son adquisiciones DICOM nativas.
Formato cerrado, un solo visualizador
- Imágenes que solo se pueden abrir con el software del fabricante
- Datos dispersos entre SQLite, JSON y un contenedor binario propietario
- Ningún vínculo con el resto del historial clínico del paciente
Estudio DICOM estándar en Orthanc
- Se abre en OHIF como cualquier otro estudio DICOM
- Un único estudio multiserie, estructurado por lesión
- Visible junto con los informes, los eventos y la línea de tiempo del paciente
El estudio generado se releyó y se verificó con las herramientas de escaneo de dicom_manager antes incluso de tocar Orthanc, y luego se importó en el PACS compartido de MediLog mediante la subida idempotente ya existente para los documentos DICOM — ninguna ruta de importación especial: desde ese momento es un estudio como otro cualquiera.
Un solo contenedor, siempre contigo
Las dos historias contadas arriba son, bajo la superficie, el mismo problema visto desde dos ángulos distintos. Normalmente un paciente lleva consigo su historia clínica en piezas sueltas: un pendrive con las imágenes de una TAC y su visualizador dedicado, un CD de otro examen que requiere otro programa más, PDF de informes dispersos entre el correo y las carpetas del móvil y, quizá — como en el caso contado en este artículo — una copia del software propietario de un centro especializado, utilizable solo allí, solo con esa contraseña, solo mientras ese programa siga funcionando en el propio ordenador.
En lugar de llevar consigo todos estos soportes y formatos distintos, tener un único contenedor digital, siempre accesible desde cualquier dispositivo, en el que cada examen — sea cual sea su origen — acabe convertido a un formato estándar e interoperable, legible hoy y dentro de diez años, por el propio MediLog o por cualquier otro sistema conforme. El trabajo de conversión DICOM descrito arriba no es un ejercicio académico: es exactamente el mecanismo que permite que un examen nacido para quedarse cerrado pase a formar parte de ese contenedor.
Sin embargo, ese mismo contenedor no está pensado solo para recibir documentos producidos por un médico o un centro. Está pensado también para que el propio paciente — o un familiar que cuida de él — pueda añadir sus propias observaciones, recogidas con los instrumentos que ya tiene en casa: un tensiómetro, una báscula conectada, un glucómetro, un reloj deportivo como Garmin. No apuntes separados del resto de la historia clínica, sino observaciones de verdad, con el mismo nivel de estructura y el mismo flujo de seguridad (vista previa, confirmación, ningún dato guardado a ciegas) reservado a los informes de laboratorio.
Este es el hilo que une las dos historias: la integración con Garmin no es «una función más» separada del resto, y la conversión DICOM no es solo un problema de interoperabilidad técnica; son dos puertas distintas hacia el mismo objetivo, una única historia clínica que el paciente tiene de verdad siempre consigo, en lugar de tener que reconstruirla cada vez a partir de un cajón lleno de CD, pendrives y contraseñas distintas.
Vibe coding: herramientas de usar y tirar, cosidas a medida
Hay un hilo técnico, además del clínico, que une las dos historias de este artículo: ninguna de las herramientas descritas — el script que genera el estudio DICOM a partir de la videodermatoscopia, la automatización que manejó la interfaz de DermaGraphix, la pequeña app independiente para el fetch local desde Garmin — se escribió a mano línea por línea. Todas se construyeron junto con un asistente de IA, describiendo con palabras el problema concreto y dejando que fuera el modelo quien produjera, y en algunos casos también ejecutara directamente, el código necesario.
Esta forma de trabajar tiene nombre, vibe coding, formalizado en febrero de 2025 por Andrej Karpathy (informático, cofundador de OpenAI y anteriormente director de IA de Tesla): pocas frases que describen lo que se quiere conseguir, usadas como prompt para un modelo de lenguaje optimizado para la programación, dejando que sea él quien escriba — y a menudo también ejecute — el código.
El vibe coding no se detiene en las herramientas menores contadas arriba: es el mismo método con el que se construyó MediLog, y con el que nació toda la plataforma solveiAgents que lo aloja — el orquestador, los agentes especializados, la infraestructura que los mantiene en pie. No es un detalle marginal que sirva solo para los scripts de apoyo: es la manera en que se escribió, desde el principio, también el código que un paciente usa cada día.
Pero cuidado con leerlo como «basta con describir la idea, lo demás viene solo». Para una herramienta menor y aislada — un script que extrae 19 imágenes de una base de datos SQLite, usado una vez y luego tirado — la creatividad puede bastar de verdad: el daño de un error es limitado, y se ve enseguida si el resultado es el deseado. Construir una plataforma entera como solveiAgents es un problema distinto. Contenedores separados para cada agente, servicios comunes reutilizados en todas partes (logging centralizado, copias de seguridad, planificación de trabajos en cola, un orquestador que decide cuándo encender y apagar qué), datos clínicos reales que no pueden permitirse un fallo silencioso: para llegar a una arquitectura que aguante hacen falta bases sólidas de informática — indispensables, no opcionales — junto con un conocimiento concreto de lo que un modelo de IA sabe hacer bien de verdad y de dónde hay que verificarlo línea por línea.
El requisito que sigue siendo común a ambos casos, pequeños y grandes, es la creatividad: la capacidad de imaginar la herramienta que de verdad hace falta, antes incluso de que exista, y de describirla con precisión a quien (o a lo que) deba construirla — la misma creatividad que hace falta para darse cuenta de que un dato de Garmin bloqueado por Cloudflare, o una videodermatoscopia encerrada en un software propietario, no son obstáculos insalvables sino problemas que se pueden sortear, pieza a pieza. A la escala de una plataforma entera, sin embargo, esa creatividad por sí sola no basta: debe apoyarse en competencias técnicas reales para convertirse en un sistema que funciona de verdad, y no solo en un prototipo que parece funcionar.
Dos historias distintas, la misma lección de fondo: en un sistema que pone de verdad al paciente en el centro, el dato clínico no puede quedar prisionero de quien lo generó primero — sea una API cloud que no se fía de tu IP o un visualizador que no prevé un botón «exportar». A veces basta con un endpoint distinto; a veces hace falta mirar cómo el software mira sus propios datos, un clic cada vez.