Prima di entrare nel merito di queste due integrazioni, vale la pena ricordare da dove nasce MediLog. In un articolo dedicato al confronto tra FSE e PHR ho spiegato perché un PHR (Personal Health Record, cartella clinica personale) sia uno strumento radicalmente diverso da un FSE (Fascicolo Sanitario Elettronico): il primo è pensato intorno al paziente, che ne ha il controllo e decide cosa contiene e chi può vederlo; il secondo è pensato intorno al servizio sanitario che lo eroga, e il paziente ne è più destinatario che proprietario.
MediLog (raccontato qui) è il PHR che ho costruito a partire proprio da quell'idea: una cartella clinica che non appartiene a nessuna struttura specifica, ma al paziente stesso — referti, documenti, immagini DICOM, osservazioni, dati wearable, tutto in un unico posto indipendentemente da quale medico o ospedale o struttura lo abbia generato. L'ho costruito prima di tutto per un uso personale e familiare: gestire la mia storia clinica e quella di chi mi sta vicino, senza dover più rincorrere referti sparsi tra portali diversi, ciascuno con le proprie credenziali e la propria interfaccia. Le due storie raccontate in questo articolo — Garmin e DICOM — sono nate entrambe da quello stesso bisogno, molto concreto.
Il fetch Garmin falliva in produzione perché Cloudflare blocca l'IP del datacenter
OCI su ogni strategia di login, non per un bug: risolto spostando il login su un'app
locale e facendo transitare il dato da uno staging MinIO temporaneo. La videodermatoscopia
Canfield DermaGraphix, chiusa in un formato proprietario senza funzione di export,
è stata estratta via automazione dell'interfaccia e riconvertita in uno studio DICOM
standard con dicom_manager, importato in Orthanc come un esame qualunque.
Uno SmartWatch che registra tutto e un servizio in cloud che non lascia uscire nulla.
MediLog è stato pensato per poter contenere anche dati provenienti da dispositivi medici o sportivi wearable. Uno SmartWatch consente di registrare dati come frequenza cardiaca continua, SpO2 (saturazione), memorizzati durante l'attività fisica e a riposo: informazioni che per molti pazienti esistono già, raccolte quotidianamente da un orologio sportivo, e che restano chiuse dentro l'app del produttore invece di finire accanto al resto della storia clinica.
Per un utente di Garmin, l'obiettivo era semplice da enunciare: recuperare attività e frequenza cardiaca da Garmin Connect e salvarle tra i dati del paziente in MediLog con lo stesso schema «anteprima → conferma» già usato per i referti di laboratorio. Nessuna credenziale Garmin memorizzata da nessuna parte, fetch (il recupero dei dati dal servizio esterno — in questo caso Garmin Connect, chiamato su richiesta per andare a prendere attività e frequenza cardiaca) sempre su richiesta esplicita, mai automatico.
Cloudflare è un servizio che si frappone tra il traffico internet e il server vero di un sito o di un'app: ogni richiesta passa prima dai suoi datacenter, che la filtrano, e solo se la ritengono legittima la lasciano proseguire verso il server reale del produttore. Nasce come protezione contro gli attacchi (assorbire ondate di traffico malevolo prima che travolgano il server di origine) e come rete di distribuzione dei contenuti, ma la funzione che qui conta davvero è la terza: il rilevamento automatico di bot (programmi che si collegano a un sito o a un servizio al posto di una persona, spesso in quantità e a velocità che un essere umano non potrebbe mai raggiungere) e di scraping (l'uso di uno di questi programmi per estrarre dati in massa da un sito o da un servizio, di solito senza che il proprietario l'abbia autorizzato). Il filtro analizza ogni richiesta — impronta TLS del client, comportamento, reputazione dell'indirizzo IP di provenienza — prima ancora che arrivi all'applicazione, cercando di distinguere un programma automatico da una persona reale.
È un servizio usatissimo — una parte enorme del traffico mondiale passa dai suoi datacenter — proprio perché proteggere un login da tentativi automatici di furto di credenziali («credential stuffing») o da scraping massivo è un problema comune a qualunque servizio con un'utenza vasta, Garmin incluso: il nostro fetch, per quanto legittimo, assomiglia dall'esterno esattamente al tipo di traffico automatizzato che questi filtri sono pensati per bloccare.
Il muro: l'IP del datacenter è già marchiato
Il primo deploy in produzione del fetch diretto — via la libreria non ufficiale
garminconnect, che replica il login web/mobile dell'app Garmin Connect —
è fallito sistematicamente. Non con un errore di autenticazione: con un rifiuto a
monte, prima ancora che le credenziali contassero qualcosa — segnalato dal protocollo
HTTP stesso con i codici 429 («troppe richieste», il server
chiede esplicitamente di rallentare o smette del tutto di rispondere) e 403
(«accesso negato», la richiesta viene riconosciuta e bloccata a prescindere).
Non errori applicativi nostri: risposte di basso livello, prima ancora che la richiesta
arrivi davvero a Garmin.
Tutte e cinque le strategie di login tentate (combinazioni di endpoint mobile/widget/portale e di libreria HTTP sottostante) venivano respinte allo stesso modo, con le stesse credenziali che funzionano senza problemi da un browser normale. Non era un bug risolvibile a colpi di retry: era la reputazione dell'indirizzo IP del nostro server a essere il problema, non il codice.
Lo stesso identico pattern — handshake applicativo rifiutato subito, riproducibile con credenziali diverse, non un rate-limit temporaneo ma un marchio sull'indirizzo stesso — ci era già capitato mesi prima con l'agente WhatsApp, mai sbloccato e alla fine rimosso dalla piattaforma. L'ipotesi più probabile in entrambi i casi: Cloudflare tratta a priori i range IP dei grandi datacenter cloud come sorgenti di traffico automatizzato, indipendentemente da cosa stia realmente succedendo dietro quella richiesta.
Il nostro server gira su Oracle Cloud Infrastructure: non abbiamo (ancora) verificato empiricamente se lo stesso blocco scatterebbe anche partendo da Azure, GCP o AWS — ma il meccanismo descritto non ha nulla di specifico a OCI, e la cautela suggerisce di considerarlo un rischio strutturale di qualunque IP a reputazione «datacenter», non una particolarità del nostro provider.
Il workaround: spostare il fetch, non il dato
La via pulita per avere accesso ai dati del servizio sarebbe quella di aderire al Garmin Connect Developer Program ufficiale, ma tutti i tentativi che ho fatto per entrare nel programma non hanno ricevuto esito e varie ricerche in rete riportano la stessa esperienza anche da parte di altri sviluppatori. Nel frattempo serviva qualcosa che funzionasse subito, senza perdere il self-service: dev'essere l'utente stesso (o un familiare) a poter recuperare i propri dati, non un intervento manuale da parte nostra ogni volta.
La soluzione adottata separa da dove si parla con Garmin da dove vive il dato finale:
Una piccola app Next.js standalone, pensata per girare in locale su un PC o una rete domestica (IP non da datacenter, mai bloccato), autenticata con lo stesso account Clerk di produzione. L'utente fa login con le proprie credenziali Garmin solo da lì; il fetch recupera attività, frequenza cardiaca e, su richiesta per singola attività, il dettaglio fine (frequenza cardiaca, quota e velocità punto per punto, non solo il riepilogo giornaliero).
Staging, cioè un'area di passaggio temporanea, non la destinazione finale del dato: il risultato (un file JSON) viene caricato, con un token dell'utente loggato, su un bucket MinIO dedicato in produzione — nessun endpoint Garmin viene mai chiamato dal server di produzione. MinIO è il servizio di storage a oggetti open source (compatibile con le stesse API di Amazon S3) che usiamo già per conservare documenti e allegati; qui però funge solo da magazzino intermedio, non da deposito permanente dei dati. I file scadono infatti da soli dopo 7 giorni, proprio perché quest'area non è pensata per conservare nulla a lungo termine, solo per farlo transitare verso l'import vero e proprio.
Dentro MediLog, una nuova sezione elenca i file in staging dell'utente e riusa esattamente lo stesso componente di anteprima e lo stesso endpoint di salvataggio già esistenti per i referti di laboratorio — nessuna logica di import duplicata.
Fetch diretto dal server
- Login Garmin eseguito dall'IP del datacenter OCI
- Bloccato su tutte le strategie testate (429 / 403)
- Nessun dato recuperabile in produzione, mai
Fetch locale + staging MinIO
- Login Garmin eseguito da IP residenziale/dev, mai bloccato
- Stessa UX self-service, un passaggio in più
- Credenziali Garmin mai viste dal server di produzione
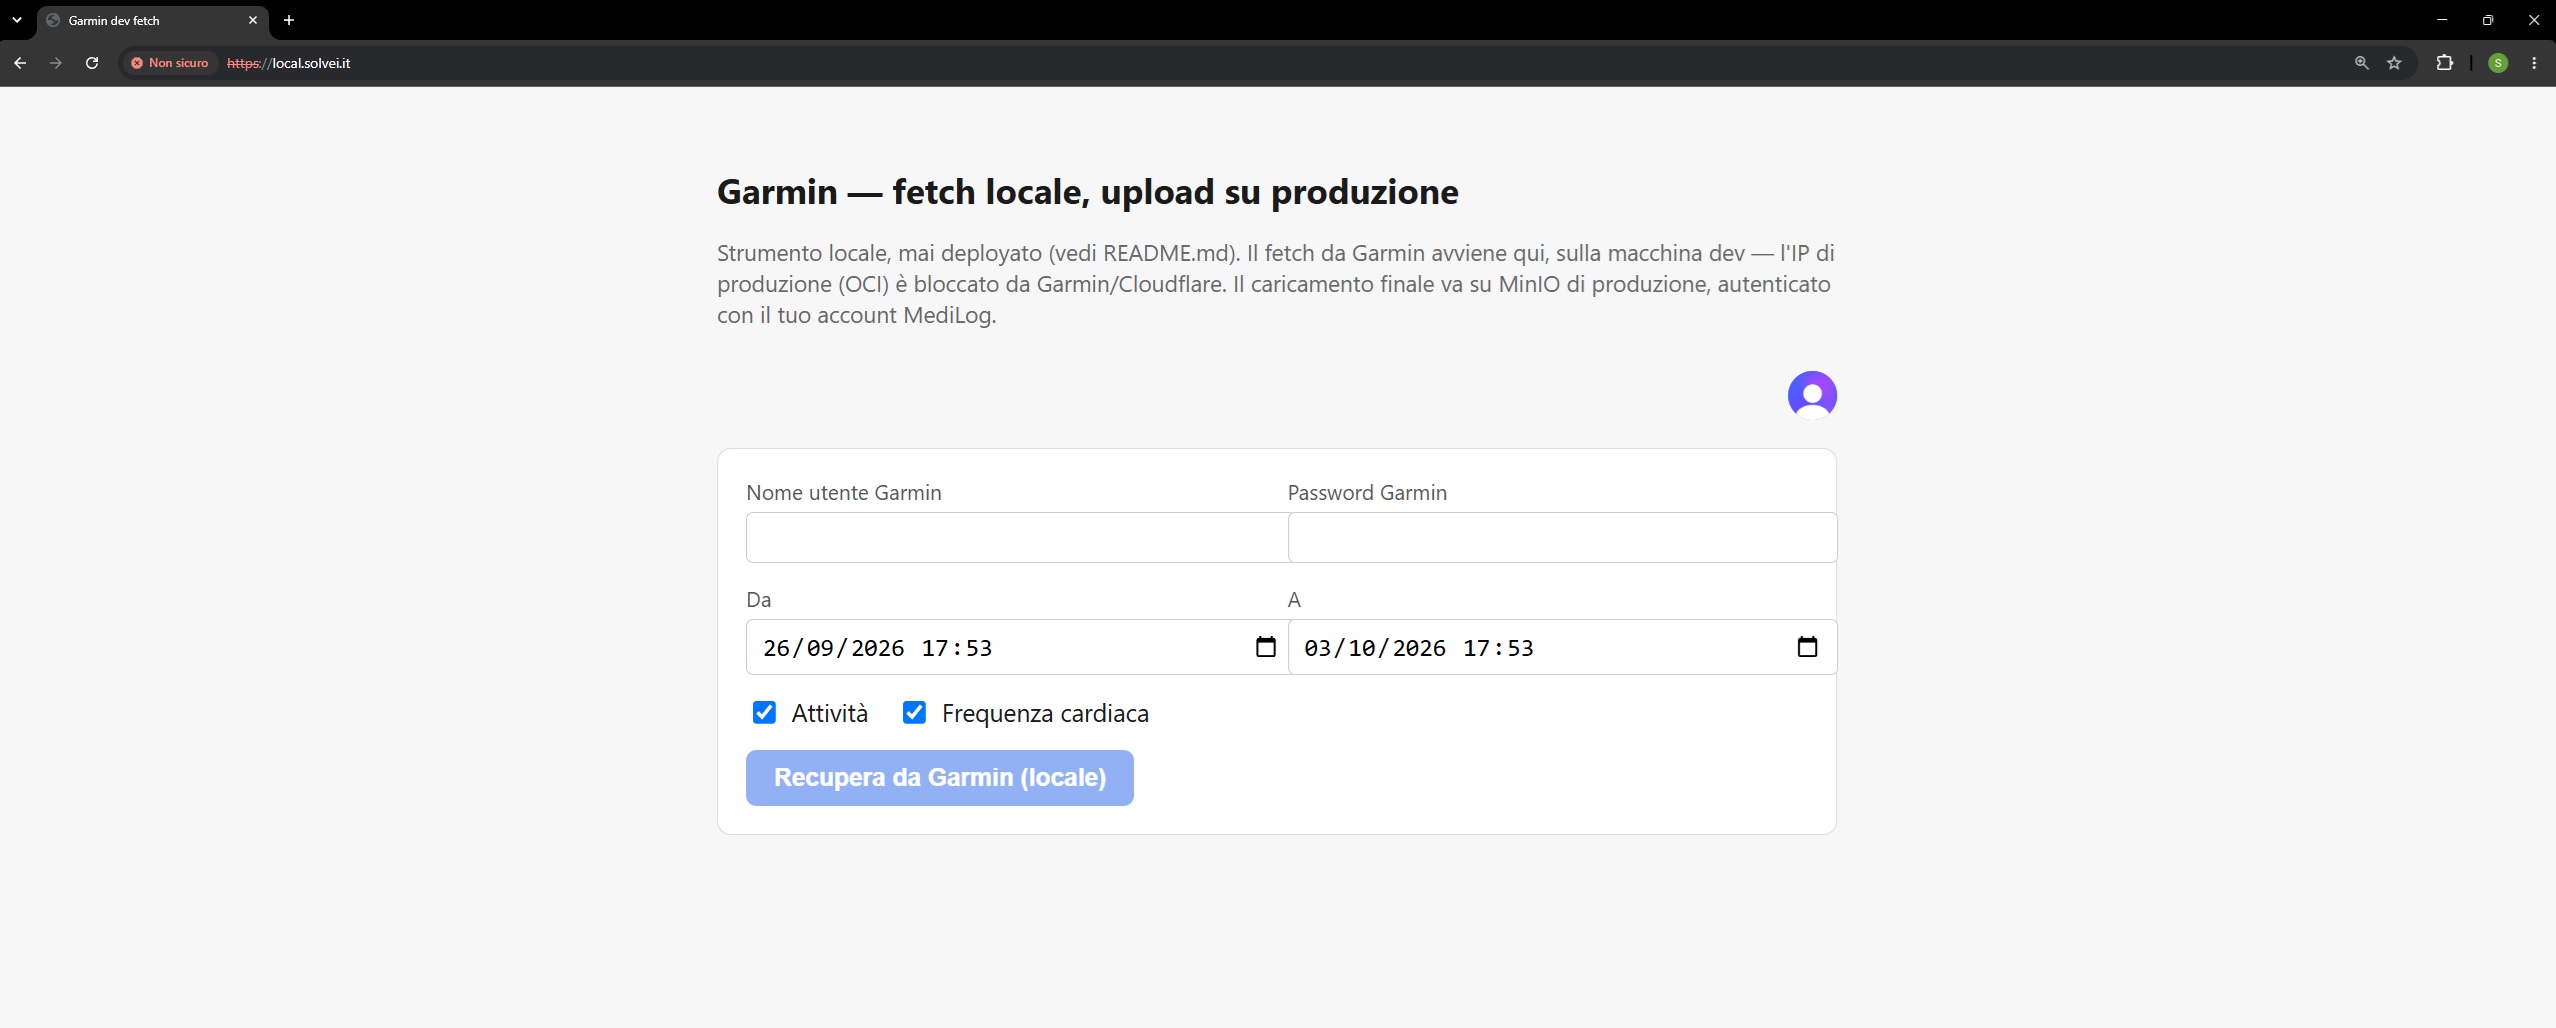
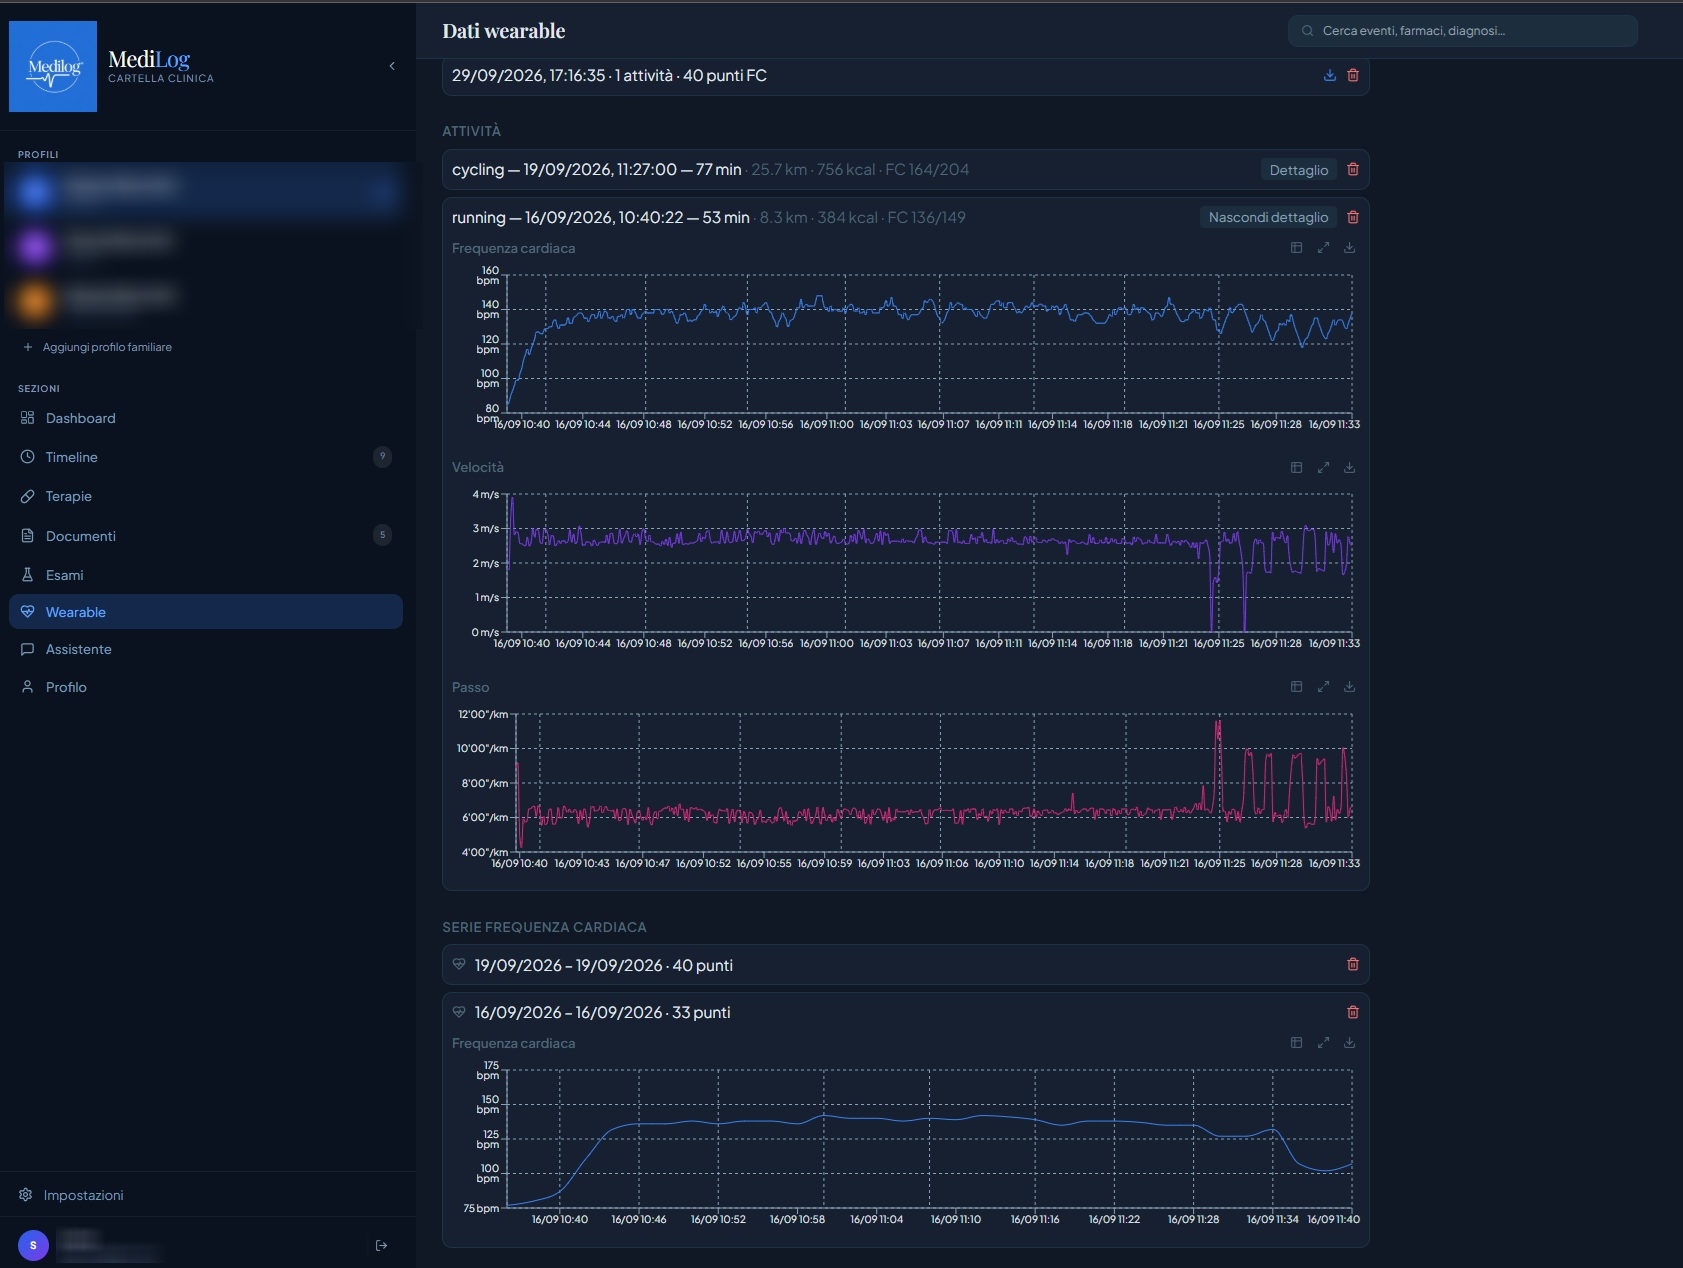
I dati wearable importati compaiono oggi anche nella Timeline clinica del paziente, intercalati agli eventi reali (non solo nella loro tab dedicata) con un colore distinto, così che un'attività sportiva o una sessione di frequenza cardiaca possano essere lette nel contesto di tutto il resto — una visita, un referto, un documento caricato nello stesso periodo.
Importare in MediLog una videodermatoscopia nata per restare chiusa
Il secondo problema è diverso nella forma ma identico nella sostanza: un dato clinico che esiste davvero, è già sul disco del paziente, ma è prigioniero di un formato e di un'applicazione che non prevedono alcuna via d'uscita standard. Prima di raccontare il caso specifico, però, vale la pena capire cosa sia davvero il DICOM e perché sia proprio quello standard, e non un formato immagine qualunque, a fare la differenza.
Cos'è davvero un file DICOM
DICOM (Digital Imaging and Communications in Medicine) è lo standard internazionale — in uso dal 1993, mantenuto dall'associazione statunitense NEMA — con cui praticamente ogni apparecchiatura di imaging medicale produce ed esporta i propri dati: TAC, risonanza magnetica, ecografo, mammografo e, come nel caso di questo articolo, anche una fotocamera clinica. Non è «un formato immagine» nel senso di JPEG o PNG: è un contenitore che lega in modo inscindibile i pixel a un blocco di metadati clinici strutturati — chi è il paziente, a quale esame appartiene l'immagine, a quale serie dentro quell'esame, con quale apparecchiatura e con quali parametri è stata acquisita, quando. Il file sa da solo a chi e a cosa appartiene, senza bisogno di un database esterno che tenga la contabilità al posto suo.
Una foto JPEG è un'isola: per sapere di chi è, a quale visita appartiene, se fa parte di una serie di altre immagini correlate, serve sempre un sistema esterno che lo ricordi al posto suo. Un file DICOM si porta dietro queste informazioni — paziente, studio, serie, istanza, data della visita (e anche altre informazioni). Non è un dettaglio tecnico da addetti ai lavori: è la differenza tra un dato che può viaggiare da solo verso qualunque sistema conforme allo standard, e uno che resta prigioniero del database (o del software) che lo ha generato.
Oltre al contenitore, DICOM definisce anche un protocollo di rete per lo scambio tra sistemi diversi: inviare uno studio a un archivio, interrogarlo, recuperarlo da un viewer. L'archivio si chiama PACS (Picture Archiving and Communication System) — il sistema, in ogni reparto di radiologia o cartella clinica digitale come MediLog, che conserva centralmente tutti gli studi di imaging e li rende disponibili ai viewer che li devono mostrare (in MediLog è Orthanc). È lo stesso linguaggio che permette a una TAC fatta in un ospedale di essere aperta, letta e misurata in un altro, su un software di un produttore completamente diverso da quello che ha fatto l'acquisizione. L'interoperabilità non è un optional dello standard: è il motivo per cui esiste.
JPEG, PNG, un file immagine qualunque
- Nessun legame nativo con paziente, esame o serie
- Serve sempre un database esterno per dare contesto clinico
- Ogni produttore organizza i propri file a modo suo
- Portabilità zero tra sistemi/software diversi
DICOM
- Paziente, studio, serie e istanza dentro il file stesso
- Leggibile da qualunque viewer conforme allo standard
- Stesso linguaggio usato da TAC, RM ed ecografi di ogni produttore
- Pensato esplicitamente per muoversi tra PACS diversi
Un esame in formato DICOM resta leggibile fra dieci anni, da un software diverso da quello che lo ha acquisito, in una struttura diversa da quella che lo ha prodotto — una seconda opinione, un cambio di medico, un trasferimento di cura non richiedono di «convertire» nulla. Un esame chiuso nel formato proprietario di un singolo produttore, invece, smette di essere davvero utilizzabile nel momento in cui quel software specifico non è più disponibile, aggiornato o semplicemente a portata di mano — esattamente la situazione descritta nel resto di questa sezione.
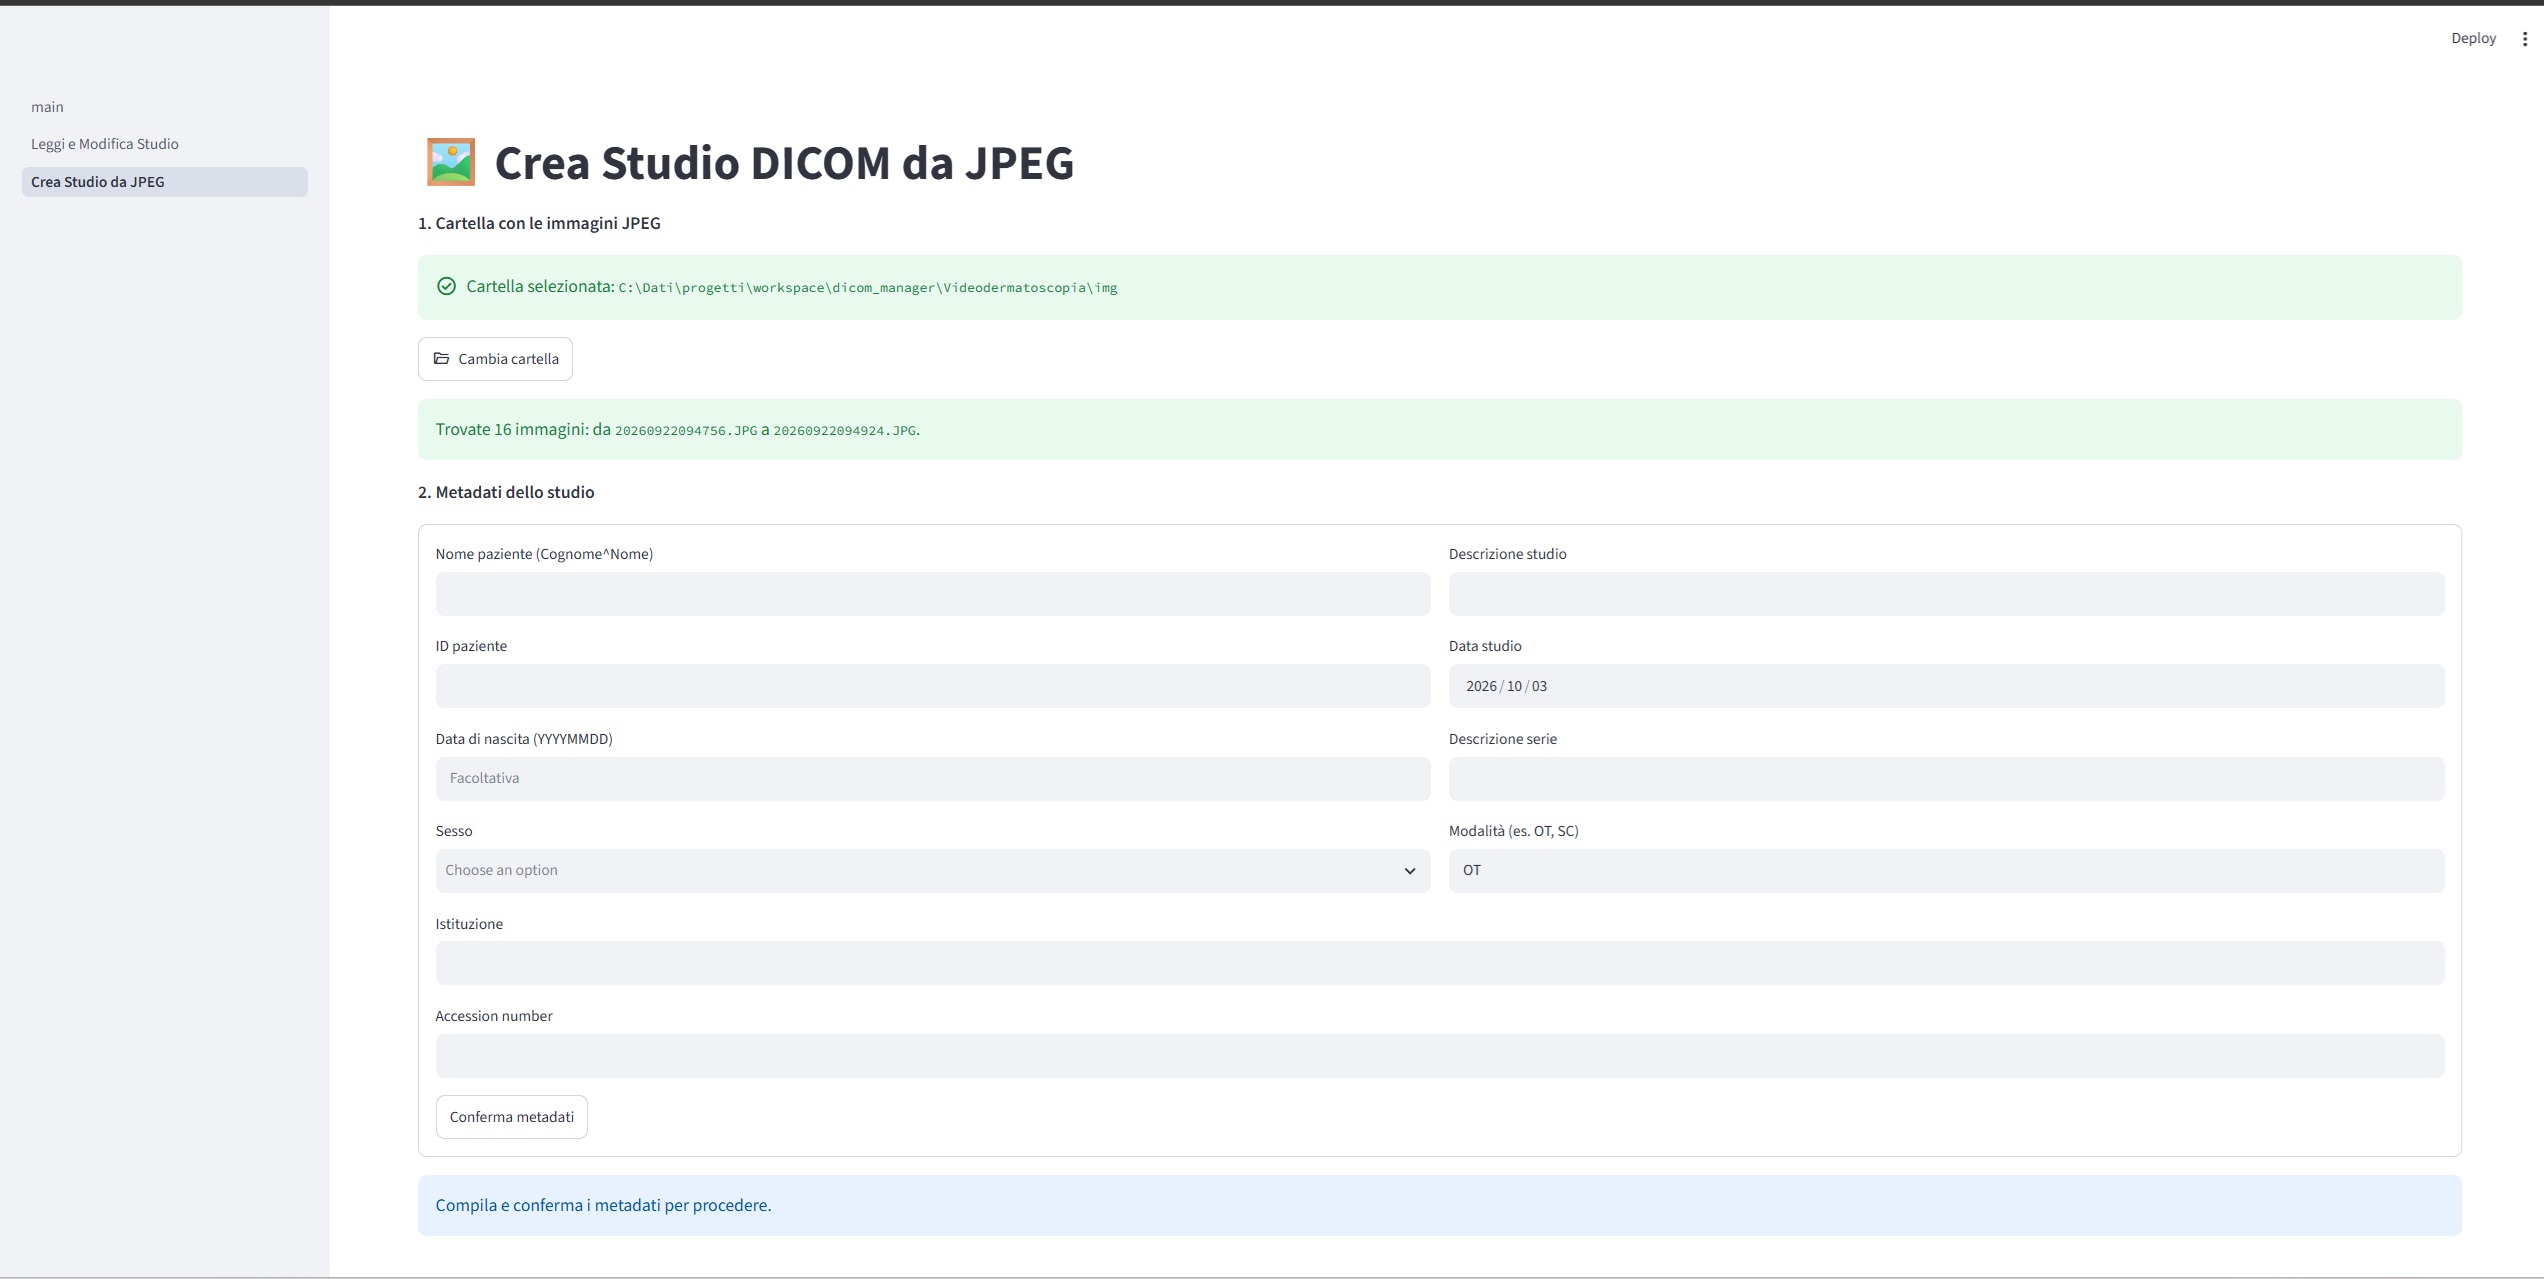
MediLog usa Orthanc come PACS per gli studi DICOM e OHIF come viewer integrato. Orthanc è un server PACS open source, leggero e pensato apposta per essere auto-ospitato: riceve, archivia e serve gli studi DICOM di tutti i pazienti, esponendo le API standard (query/retrieve) che qualunque viewer conforme sa interrogare — è il magazzino centrale a cui ogni esame, qualunque sia la sua origine, finisce per appoggiarsi. OHIF (Open Health Imaging Foundation) è invece il viewer: il programma, anch'esso open source e basato su web, con cui lo studio archiviato in Orthanc viene davvero mostrato e navigato — zoom, scorrimento tra le immagini di una serie, misurazioni — integrato direttamente nella pagina di MediLog invece di essere un'applicazione separata da aprire a parte. Per farci entrare qualunque cosa che non sia già DICOM nativo (foto cliniche, referti scansionati come immagini, acquisizioni di apparecchi che parlano solo il proprio formato proprietario) abbiamo costruito uno strumento dedicato, dicom_manager: un'app Streamlit standalone che legge, visualizza, modifica e soprattutto crea studi DICOM a partire da semplici immagini JPEG, con un flusso di salvataggio multi-step pensato apposta per non toccare mai gli originali.
Il caso concreto: la videodermatoscopia chiusa in DermaGraphix
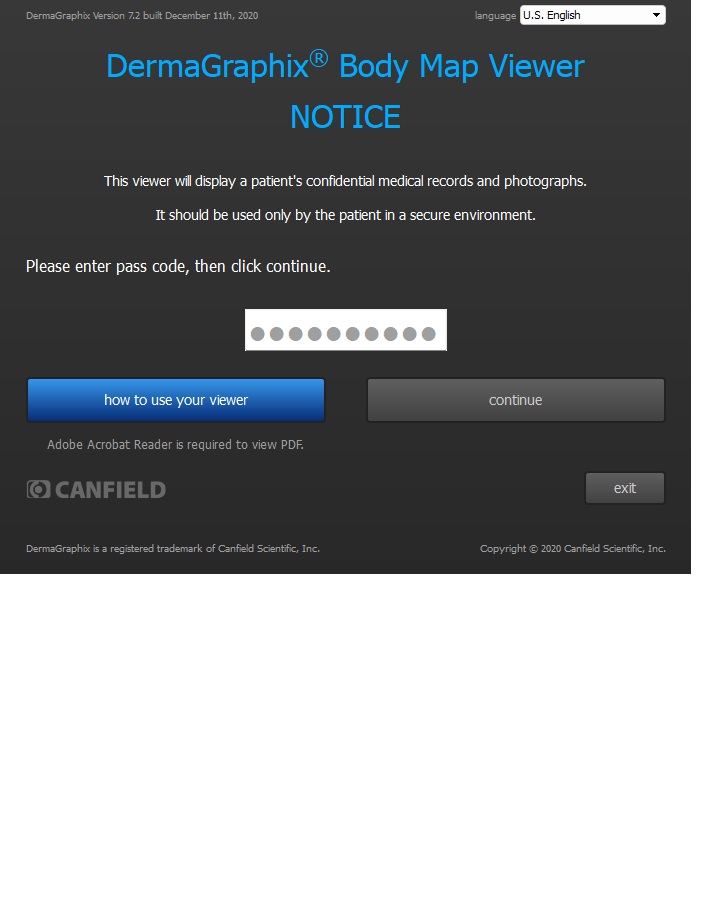
Lo studio dermatologico che esegue il mole-mapping (total-body photography + dermatoscopia ravvicinata delle lesioni da monitorare nel tempo) non consegna di norma le immagini: al massimo, su richiesta esplicita del paziente, fornisce una copia portabile del software del produttore — Canfield DermaGraphix (nome commerciale della piattaforma VECTRA) — con cui rivederle, protetta da una password personale. Nessun pulsante «esporta» da nessuna parte nell'interfaccia.
Dentro la cartella del paziente: una fotocamera reflex standard produce 16 foto corpo
intero in JPEG normalissimo, leggibile da chiunque. Ma l'algoritmo di rilevamento
automatico delle lesioni salva oltre mille candidati per foto dentro file JSON
(con i ritagli incorporati in base64), le lesioni confermate clinicamente vivono in un
database SQLite separato, e le immagini dermatoscopiche vere e proprie
— quelle acquisite con la sonda ravvicinata — sono salvate in un contenitore
binario proprietario (.t2k) senza alcuna firma JPEG o PNG riconoscibile:
illeggibile con qualunque strumento standard.
Tre formati diversi, nessuno dei quali espone un'immagine direttamente apribile — tranne, appunto, dentro il software stesso. L'unico modo per vedere davvero una dermatoscopia era farla renderizzare al visualizzatore e catturarla da lì.
Interrogare il database, non indovinarlo
Prima di arrivare allo screen-scraping, però, serviva capire quali immagini
catturare. Il software mostra solo le lesioni confermate dal dermatologo — un numero
molto più piccolo delle migliaia di candidati algoritmici grezzi. Interrogando
direttamente il database SQLite del software (con il modulo nativo node:sqlite
di Node.js, in sola lettura) è emerso lo schema reale: una tabella LESION
con le lesioni cliniche tracciate, una tabella di collegamento LESION_IMAGE che
lega ogni lesione alla sua foto di contesto body-wide e, quando esiste, alla sua
acquisizione dermatoscopica dedicata.
Questo ha permesso di sapere in anticipo, senza aprire nulla a occhio, esattamente quali lesioni avessero davvero un'immagine dermatoscopica associata e quali no — risparmiando cicli di cattura inutili e rendendo la verifica finale un controllo puntuale, non una caccia al buio.
Quando l'unica API è l'interfaccia grafica
Senza alcuna funzione di export, l'estrazione delle immagini dermatoscopiche è diventata automazione dell'interfaccia: un assistente AI ha pilotato direttamente l'applicazione Windows — attivando la finestra giusta, inserendo il numero di ciascuna lesione nel campo di ricerca, aspettando il caricamento dell'immagine e catturando lo schermo — una volta per ciascuna lesione clinicamente tracciata, verificando ogni cattura confrontando a video il numero atteso con l'etichetta effettivamente mostrata dal software.
Non uno script che «legge» un file: una sequenza di click e tasti simulati, con tutte le difficoltà tipiche dell'automazione GUI — il focus che scappa verso il terminale invece che restare sulla finestra dell'app, il nome del processo che cambia dopo il login, un campo di ricerca che a volte «parte» prima che la digitazione sia completa. Ogni intoppo risolto con l'attesa esplicita o la verifica giusta, non con un timeout più lungo buttato lì a caso.
Tutto il processo è avvenuto sul disco esterno del paziente, con le credenziali del visualizzatore fornite dal paziente stesso, senza che un solo byte lasciasse quella macchina verso servizi esterni.
Dalle immagini estratte a uno studio DICOM vero
Con le immagini finalmente in mano come normali file JPEG, è entrato in gioco
dicom_manager: non la sua interfaccia Streamlit, ma la libreria sottostante
(dicom_lib/convert.py), richiamata da uno script dedicato scritto per
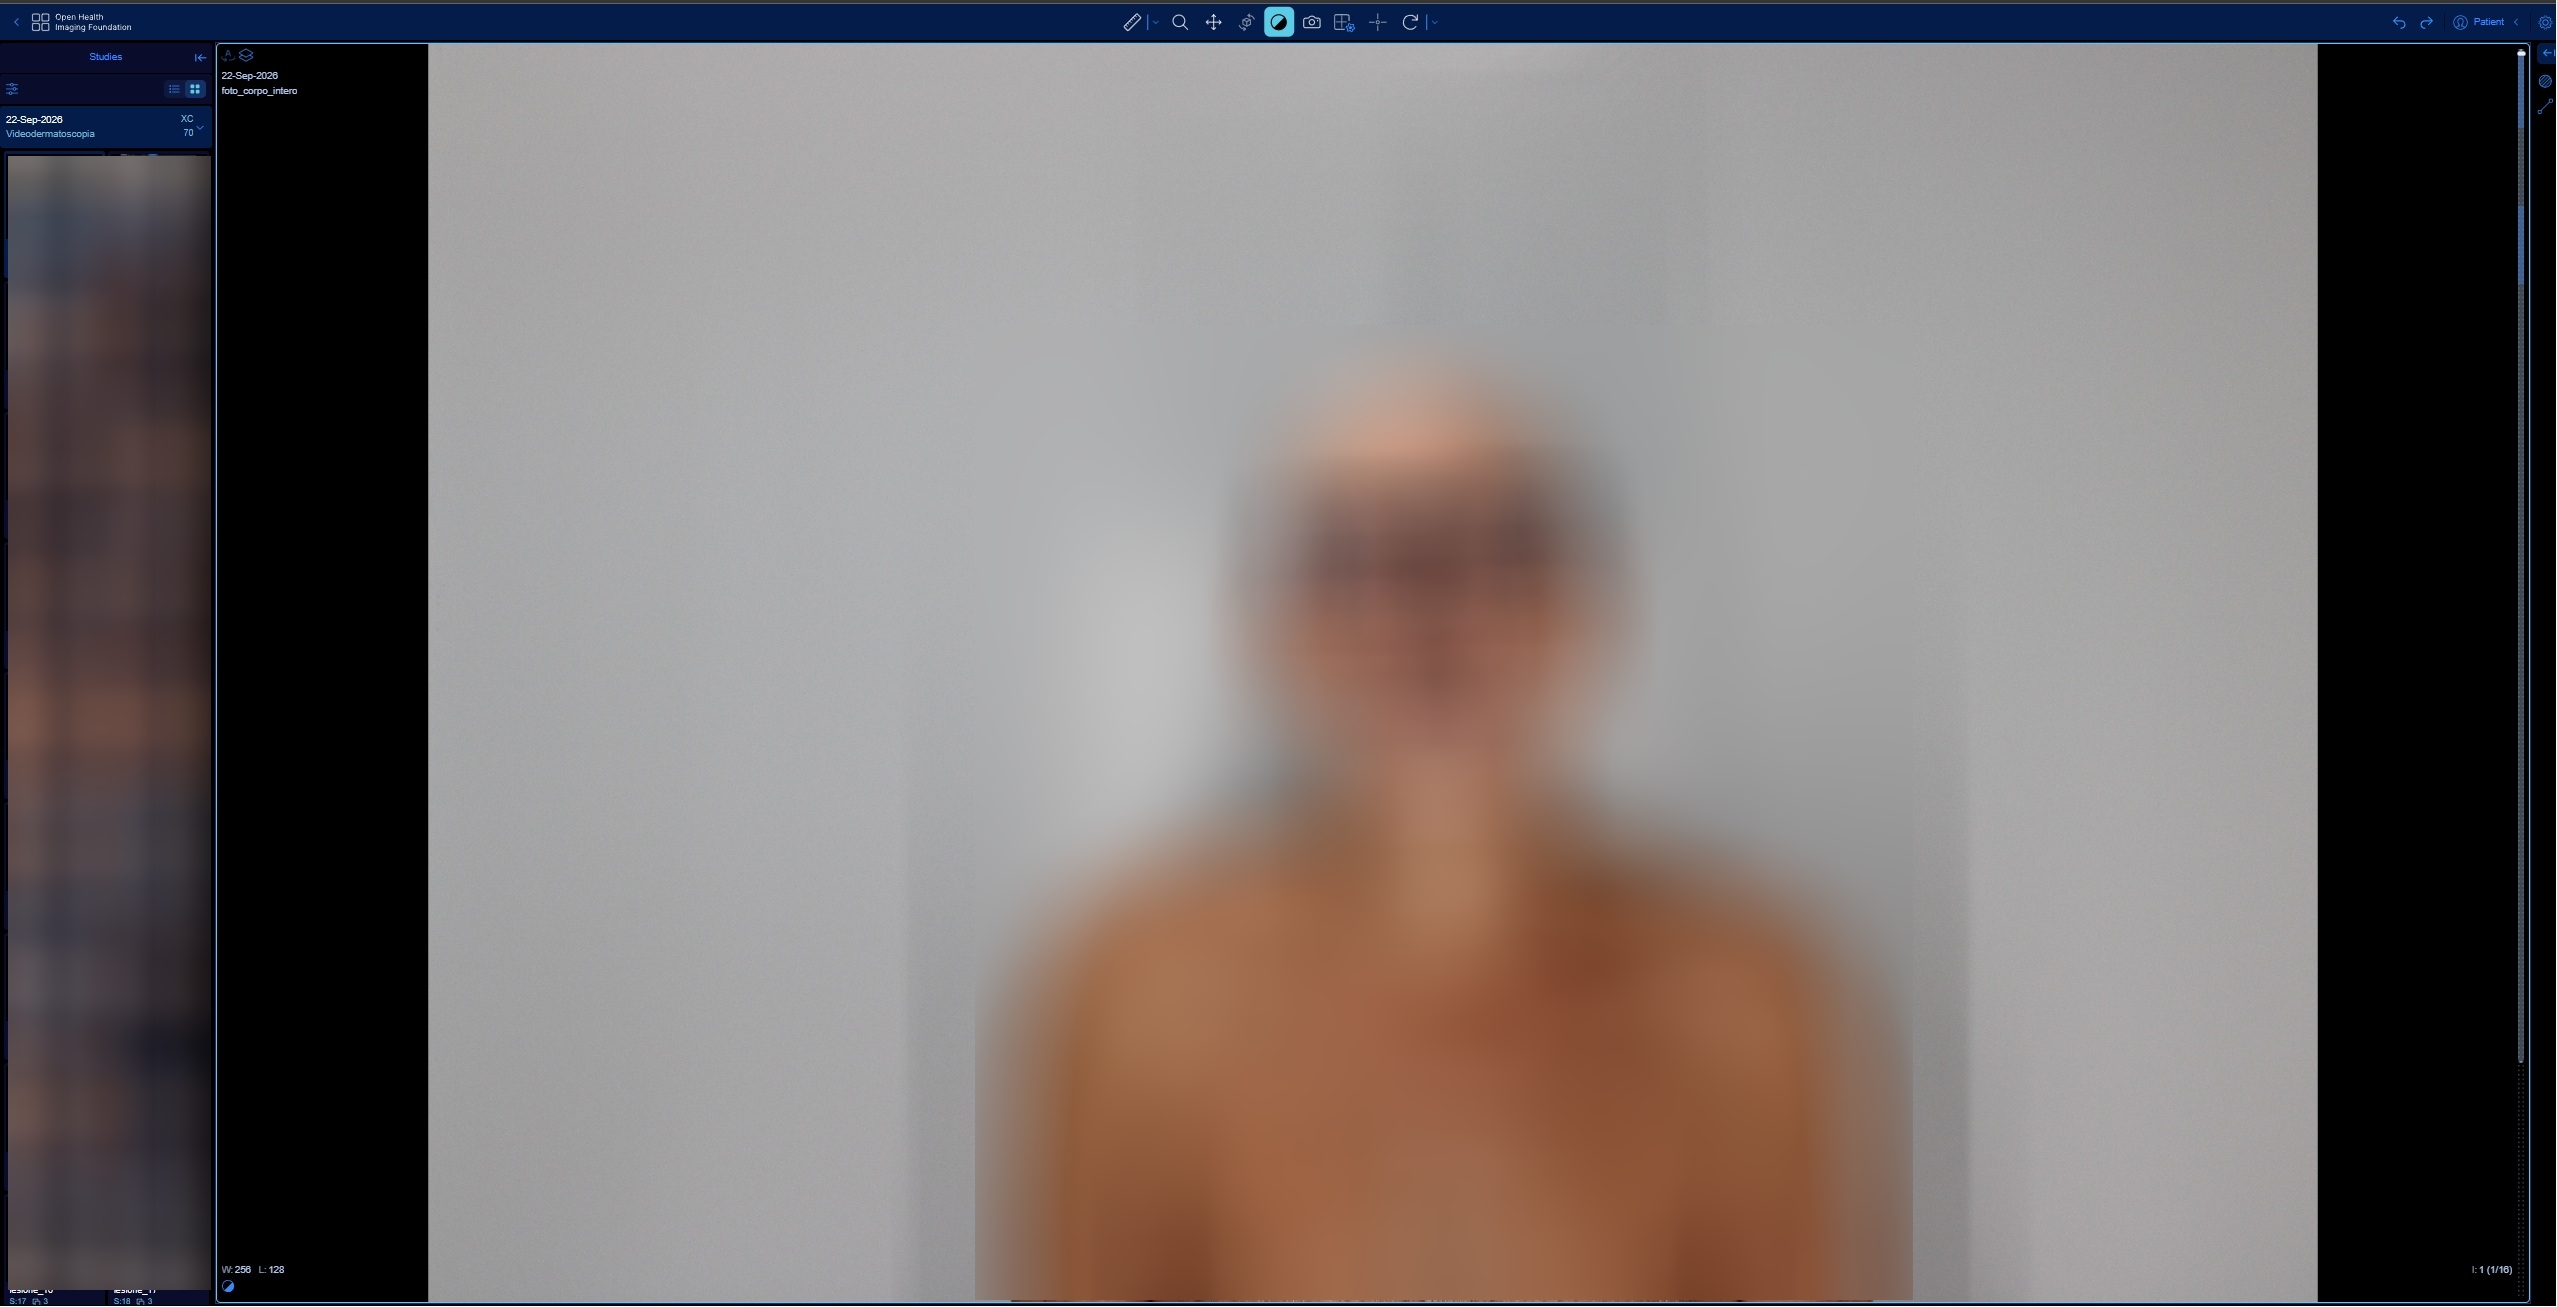
l'occasione. Lo studio generato riproduce fedelmente la struttura clinica della seduta:
- una serie con le foto corpo intero, nell'ordine in cui sono state scattate;
- per ogni lesione tracciata, una serie propria con il ritaglio di contesto, lo screenshot dell'ubicazione sul corpo e — quando disponibile — l'immagine dermatoscopica ravvicinata;
- un unico
StudyInstanceUIDcondiviso, così che tutte le serie restino raggruppate come un solo esame nel viewer.
I JPEG originali vengono incorporati così come sono, senza ricodifica: la stessa
qualità dell'originale, a una frazione dello spazio di un DICOM non compresso (lo
studio d'esempio passa da circa 1,3 GB a circa 126 MB). La modalità
assegnata è XC — fotografia da camera esterna — la più
adatta a foto cliniche e dermatoscopia che non sono acquisizioni DICOM native.
Formato chiuso, un solo visualizzatore
- Immagini apribili solo dal software del produttore
- Dati sparsi tra SQLite, JSON e un contenitore binario proprietario
- Nessun collegamento con il resto della storia clinica del paziente
Studio DICOM standard in Orthanc
- Apribile in OHIF come qualunque altro studio DICOM
- Un unico studio multi-serie, strutturato per lesione
- Visibile insieme a referti, eventi e timeline del paziente
Lo studio generato è stato riletto e verificato con gli strumenti di scansione di
dicom_manager prima ancora di toccare Orthanc, poi importato nel PACS condiviso
di MediLog tramite l'upload idempotente già esistente per i documenti DICOM —
nessun percorso di import speciale: da quel momento è uno studio come un altro.
Un contenitore solo, sempre con sé
Entrambe le storie raccontate sopra sono, sotto la superficie, lo stesso problema visto da due angolazioni diverse. Normalmente un paziente si porta dietro la propria storia clinica in pezzi sparsi: una chiavetta USB con le immagini di una TAC e il suo visualizzatore dedicato, un CD di un altro esame che richiede un altro programma ancora, PDF di referti sparsi tra email e cartelle del telefono, e magari — come nel caso raccontato in questo articolo — una copia del software proprietario di uno studio specialistico, utilizzabile solo lì, solo con quella password, solo finché quel programma continua a funzionare sul proprio computer.
Invece di portarsi dietro tutti questi supporti e formati diversi, avere un unico contenitore digitale, sempre raggiungibile da qualunque dispositivo, in cui ogni esame — qualunque sia stata la sua origine — finisce convertito in un formato standard e interoperabile, leggibile oggi e tra dieci anni, da MediLog stesso o da qualunque altro sistema conforme. Il lavoro di conversione DICOM descritto sopra non è un esercizio accademico: è esattamente il meccanismo che permette a un esame nato per restare chiuso di entrare a far parte di quel contenitore.
Lo stesso contenitore, però, non è pensato solo per ricevere documenti prodotti da un medico o una struttura. È pensato anche perché il paziente stesso — o un familiare che se ne prende cura — possa aggiungere le proprie osservazioni, raccolte con gli strumenti che già ha in casa: un misuratore di pressione, una bilancia connessa, un glucometro, un orologio sportivo come Garmin. Non appunti separati dal resto della cartella clinica, ma osservazioni vere, con lo stesso livello di struttura e lo stesso flusso di sicurezza (anteprima, conferma, nessun dato salvato alla cieca) riservato ai referti di laboratorio.
È questo il filo che lega le due storie: l'integrazione Garmin non è «una funzione in più» separata dal resto, e la conversione DICOM non è solo un problema di interoperabilità tecnica — sono due porte diverse verso lo stesso obiettivo, un'unica cartella clinica che il paziente ha davvero sempre con sé, invece di doverla ricostruire ogni volta da un cassetto pieno di CD, chiavette e password diverse.
Vibe coding: strumenti usa-e-getta, cuciti su misura
C'è un filo tecnico, oltre a quello clinico, che lega le due storie di questo articolo: nessuno degli strumenti descritti — lo script che genera lo studio DICOM dalla videodermatoscopia, l'automazione che ha pilotato l'interfaccia di DermaGraphix, la piccola app standalone per il fetch locale da Garmin — è stato scritto a mano riga per riga. Sono stati tutti costruiti insieme a un assistente AI, descrivendo a parole il problema specifico e lasciando che fosse il modello a produrre, e in alcuni casi anche a eseguire direttamente, il codice necessario.
Questo modo di lavorare ha un nome, vibe coding, formalizzato nel febbraio 2025 da Andrej Karpathy (informatico, tra i fondatori di OpenAI e in precedenza direttore AI di Tesla): poche frasi che descrivono cosa si vuole ottenere, usate come prompt per un modello linguistico ottimizzato per la programmazione, lasciando che sia lui a scrivere — e spesso anche a eseguire — il codice.
Il vibe coding non si ferma agli strumenti minori raccontati sopra: è lo stesso metodo con cui è stato costruito MediLog, e con cui è nata l'intera piattaforma solveiAgents che lo ospita — l'orchestratore, i singoli agenti specializzati, l'infrastruttura che li tiene in piedi. Non è un dettaglio marginale buono solo per gli script di appoggio: è il modo in cui è stato scritto, dall'inizio, anche il codice che un paziente usa ogni giorno.
Ma attenzione a non leggerlo come «basta descrivere l'idea, il resto viene da sé». Per uno strumento minore e isolato — uno script che estrae 19 immagini da un database SQLite, usato una volta e poi buttato — la creatività può davvero bastare: il danno di un errore è contenuto, e si vede subito se il risultato è quello voluto. Costruire una piattaforma intera come solveiAgents è un problema diverso. Container separati per ogni agente, servizi comuni riusati ovunque (logging centralizzato, backup, scheduling dei job in coda, un orchestratore che decide quando accendere e spegnere cosa), dati clinici reali che non possono permettersi un bug silenzioso: per arrivare a un'architettura che tiene, servono basi solide di informatica — indispensabili, non facoltative — insieme a una conoscenza concreta di cosa un modello AI sappia davvero fare bene e dove invece vada verificato riga per riga.
Il requisito che resta comune a entrambi i casi, piccoli e grandi, è la creatività: la capacità di immaginare lo strumento che serve davvero, prima ancora che esista, e di descriverlo con precisione a chi (o a cosa) lo dovrà costruire — la stessa creatività che serve per accorgersi che un dato Garmin bloccato da Cloudflare, o una videodermatoscopia chiusa in un software proprietario, non sono ostacoli insormontabili ma problemi che si possono aggirare, un pezzo alla volta. Sulla scala di una piattaforma intera, però, quella creatività da sola non basta: deve appoggiarsi a competenze tecniche reali per diventare un sistema che funziona davvero, e non solo un prototipo che sembra funzionare.
Due storie diverse, la stessa lezione di fondo: in un sistema che mette davvero il paziente al centro, il dato clinico non può restare prigioniero di chi lo ha generato per primo — che sia un'API cloud che non si fida del tuo IP o un visualizzatore che non prevede un pulsante «esporta». A volte basta un endpoint diverso; a volte serve guardare il software guardare i propri dati, un click alla volta.