De la visión por computador clásica (clasificación, detección, segmentación, estimación de pose) a lo que sabe hacer hoy una webcam cualquiera con modelos de código abierto como MediaPipe: dos proyectos construidos de verdad — el theremin virtual (estimación de pose de las manos, inspirado en el instrumento homónimo de 1920) y EmoLens (reconocimiento de emociones y microexpresiones faciales basado en el FACS) — y un tercer proyecto, CourtIntelligence, que por ahora solo existe como plan.
Antes incluso del deep learning "en tiempo real": la visión por computador clásica
La visión por computador es la rama de la inteligencia artificial que permite a las máquinas procesar, analizar y comprender imágenes y vídeo, un campo de investigación mucho más antiguo que la IA generativa y los LLM multimodales de hoy. Antes de contar los dos proyectos que hemos construido de verdad — el theremin virtual (una forma de estimación de pose aplicada a las manos) y EmoLens (una forma de clasificación aplicada a las microexpresiones del rostro) — conviene mirar el mapa completo de las tareas que aborda este campo: ambos son, en el fondo, casos particulares de esta taxonomía más general.
Tareas sobre una sola imagen
"¿Qué hay en esta foto?"
Asigna una etiqueta a una imagen entera eligiendo entre un conjunto predefinido de clases (p. ej., "persona", "coche"). Es la tarea más sencilla y la primera en la que las redes convolucionales superaron el rendimiento humano, una década antes que los transformers.
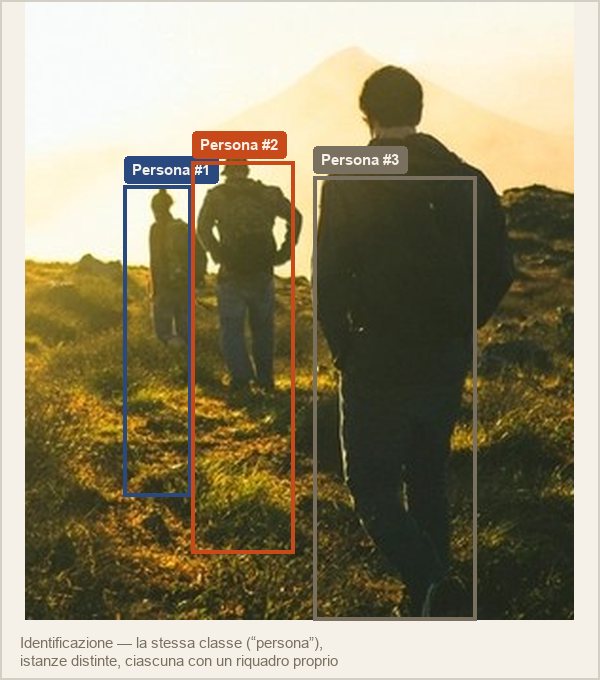
"¿Quién es esta persona?"
No basta con reconocer que "es un rostro humano" (clasificación): hay que reconocer qué instancia concreta de esa clase es, esta persona y no otra. Es la base del reconocimiento facial.
"¿Dónde está, exactamente?"
Localiza uno o más elementos en una imagen con un cuadro delimitador. A menudo es una fase preliminar: detectar un rostro antes de analizarlo, o un componente dañado antes de clasificar la avería. Es la tarea central de herramientas como YOLO y Detectron2.
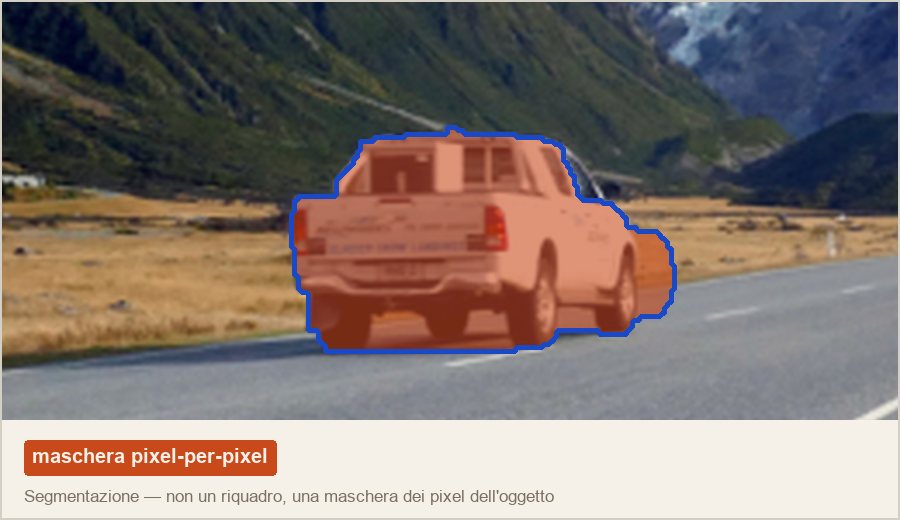
"¿Qué píxeles, exactamente?"
No un cuadro sino una máscara píxel a píxel. La segmentación de objetos devuelve una máscara por clase (todos los píxeles "coche"); la segmentación de instancias, una máscara distinta para cada coche reconocido, una tarea en la que las redes neuronales aún están lejos de la precisión del cerebro humano.
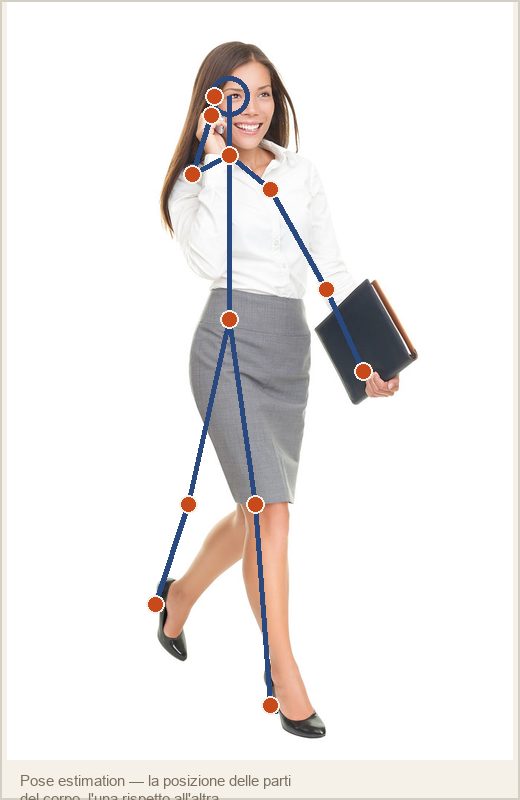
"¿Cómo está orientado/posicionado?"
Para los objetos rígidos, la posición y la orientación en el espacio 3D respecto a la cámara (útil para la robótica). Para los cuerpos humanos, la posición de las partes del cuerpo unas respecto a otras: exactamente la tarea que MediaPipe Hands resuelve para nuestro theremin, solo que aplicada a las manos en lugar de al cuerpo entero.
Tareas sobre un flujo de vídeo
La visión artificial no se detiene en la imagen individual: algunas tareas requieren considerar una secuencia en su conjunto, no fotograma a fotograma, para tener en cuenta la coherencia temporal. El seguimiento (tracking) localiza un elemento concreto a lo largo de todo el flujo de vídeo: podría hacerse aplicando la detección a cada fotograma, pero es mucho más eficiente usar los resultados de los fotogramas anteriores para predecir la posición futura, aprovechando la continuidad del movimiento. El reconocimiento de acciones va más allá: reconocer un gesto o un movimiento (bailar, dibujar un círculo) requiere por definición una secuencia continua, del mismo modo que no se puede entender una frase a partir de palabras aisladas y desordenadas. Es el principio que hay detrás del debouncer que usamos en el theremin para confirmar un puño cerrado solo tras varios fotogramas consecutivos, no a partir de un único fotograma aislado.
Las mismas tareas, una interfaz completamente distinta
Hasta hace pocos años, cada una de estas cinco tareas requería un modelo dedicado, entrenado con un conjunto de datos específico para esa tarea. Los LLM multimodales cambian la interfaz: un solo modelo, un prompt en lenguaje natural, y la respuesta llega como texto libre en lugar de como clase/cuadro/máscara estructurados. En SOLVEIAGENTS (https://blog.solvei.it/es/blog/solveiagents-medilog.html) esto se traduce en dos agentes — agent-image y agent-medical — que interpretan el contenido de una imagen cualquiera bajo petición, sin que nadie haya entrenado un modelo expresamente para esa tarea concreta. Tres ejemplos reales, tomados del uso cotidiano de la plataforma.
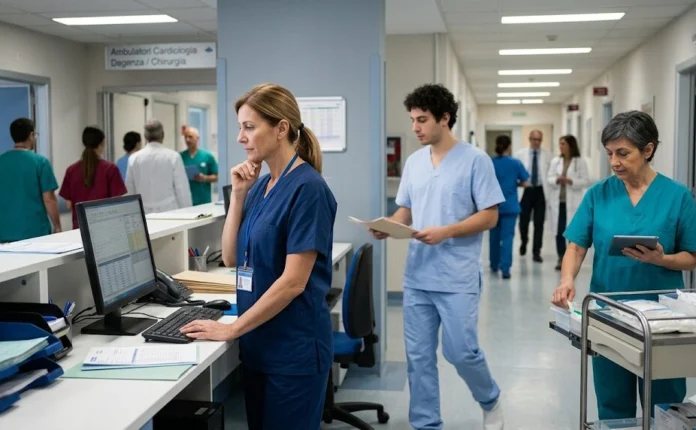
Ninguna clase predefinida, ningún cuadro delimitador: el modelo describe sujetos, fondo, colores dominantes, composición e incluso el texto legible de un cartel del pasillo, una tarea que hasta hace pocos años habría requerido la combinación de al menos cuatro modelos especializados (detección de personas, reconocimiento de colores, OCR, estimación de profundidad).
Sujeto principal
En primer plano (izquierda): una mujer de pelo rubio recogido en trenzas, uniforme de enfermera azul oscuro, tarjeta identificativa. Sentada a una mesa, la mano derecha en el teclado numérico del ordenador, la otra apoyada en la barbilla en un gesto reflexivo. Sobre la mesa, documentos dispersos, un monitor con datos médicos, un teléfono fijo, bolígrafos.
En el centro: un hombre de pelo oscuro, uniforme de enfermero azul claro, camina hacia la derecha con una hoja en la mano.
A la derecha (primer plano): una mujer de pelo corto y gris, uniforme verde agua, empuja un carro médico lleno de paquetes y documentos, con una tableta en la mano.
Fondo
El pasillo se extiende hacia el interior, iluminado por luces fluorescentes. En la pared izquierda, un cartel: "Ambulatori Cardiologia Degenza / Chirurgia". Al fondo, otras personas con uniforme médico y un hombre con traje oscuro y corbata, probablemente personal administrativo.
Colores dominantes
Tonalidades clínicas (azules claros, verdes, grises, blancos), con los colores de los uniformes (azul oscuro, azul claro, verde agua) predominando sobre los tonos neutros de paredes y suelo. La luz fluorescente blanca contribuye a la atmósfera fría típica de un entorno hospitalario.
Composición
Perspectiva de "fondo profundamente recortado", con la zona de la mesa en primer plano como punto focal mientras el pasillo se alarga creando profundidad. Los tres sujetos se distribuyen de forma dinámica: actividad laboral, movimiento, acción operativa.
Textos legibles
En el cartel: "Ambulatori Cardiologia Degenza / Chirurgia", claro y bien visible. Ningún otro elemento textual relevante (ninguna escritura legible en pantalla ni en documentos).
Elementos relevantes
Objetos médicos y administrativos (carro, monitor, documentos, bolígrafos); ambientación clínica típica (iluminación fluorescente, paredes neutras, pasillo largo); movimiento humano dinámico que refleja la actividad cotidiana de los profesionales sanitarios.
El mismo agente se presta también a un uso más insólito: el análisis grafológico de una nota escrita a mano:
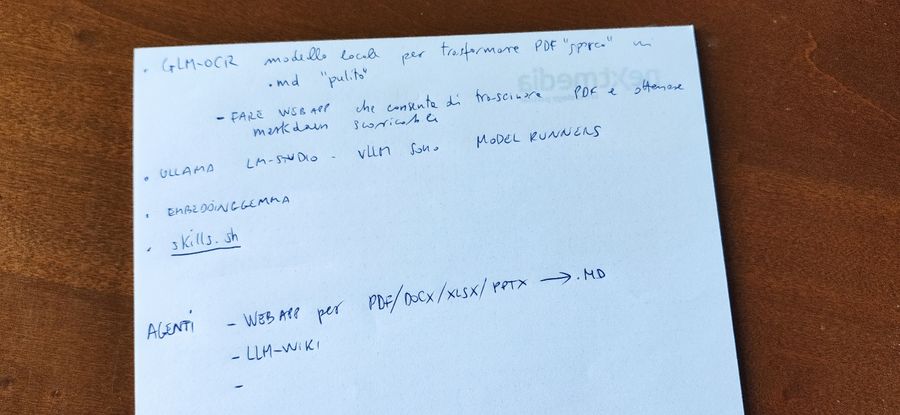
Descripción de la imagen
Una hoja de papel blanco, probablemente un bloc de notas, apoyada sobre una superficie oscura de madera. El texto está escrito a mano con un bolígrafo de tinta negra: una lista de notas técnicas organizadas en puntos, con predominio de términos informáticos y acrónimos.
Presión
Observación: constante y media, sin fuertes variaciones de grosor en el trazo, salvo algunos trazos finales más ligeros.
Interpretación: equilibrio emocional y control racional, ningún signo de impulsividad agresiva ni de extrema fragilidad.
Tamaño
Observación: escritura de tamaño medio, con tendencia a la compacidad, especialmente en las palabras técnicas ("GLM-OCR", "LM-STUDIO").
Interpretación: persona adaptable, sentido de la medida, prefiere la eficiencia a la teatralidad.
Inclinación
Observación: predominantemente vertical, con ligeras oscilaciones hacia la derecha en algunas palabras.
Interpretación: predominio de la razón sobre la emoción; rasgo típico de quien es analítico y está orientado al objetivo.
Ritmo y regularidad
Observación: ritmo rápido y funcional; letras no perfectamente formadas pero coherentes, con simplificación de algunos trazos para acelerar la escritura.
Interpretación: mente rápida y pragmática, que privilegia el contenido y la velocidad de captura frente a la forma estética.
Conexiones entre letras
Observación: letras sueltas o unidas de forma intermitente, escritura "híbrida" entre imprenta y cursiva.
Interpretación: pensamiento sintético, inteligencia que avanza por bloques lógicos más que por flujos emocionales continuos.
Márgenes y espaciado
Observación: márgenes a la izquierda respetados pero irregulares; espaciado amplio y aireado entre las líneas, variable entre las palabras.
Interpretación: método de trabajo esquemático, costumbre de dejar espacio para ampliaciones futuras; típico de quien planifica procesos técnicos.
Perfil sintético
Perfil fuertemente orientado a la racionalidad, la pragmática y la eficiencia: una mentalidad analítica, acostumbrada a manejar flujos de información complejos. Ningún espacio para el adorno ni para la emotividad superficial; un perfil técnico/profesional, disciplinado pero rápido, capaz de síntesis y con un fuerte autocontrol.
Texto extraído (OCR)
FARE WEB APP che consente di trascinare PDF e ottenere markdown scorribile
OLLAMA LM-STUDIO - VLLM sono MODEL RUNNERS
EMBEDDING GEMMA — skills.sh
AGENTI - WEB APP per PDF/DOCX/XLSX/PPTX → .MD — LLM-WIKI
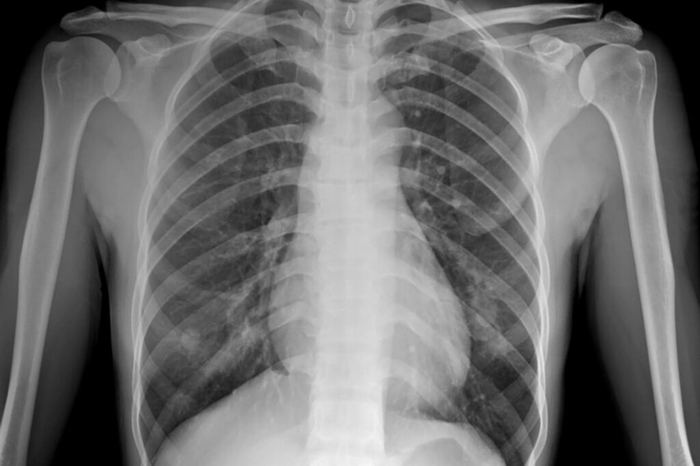
agent-medical aplica el mismo principio en el ámbito clínico, con un modelo distinto y un prompt de sistema orientado al diagnóstico por imagen:
Descripción de la imagen
Localización: tórax, proyección anteroposterior (PA).
Morfología: estructura ósea completa (escápulas, clavículas, costillas) con bordes bien definidos; corazón en posición central, relación cardiotorácica normal (≤50 %); pulmones con opacidades segmentarias en el área inferior derecha e izquierda, que sugieren infiltración parenquimatosa.
Bordes: las opacidades tienen márgenes irregulares y mal delimitados, típicos de procesos inflamatorios.
Signos clínicos relevantes
La presencia de opacidades segmentarias y una distribución focalizada sugiere un proceso infeccioso, como una neumonía. Ningún signo de pleuritis (seno costofrénico no romo), ni de derrame pleural ni de neumotórax.
Diagnóstico diferencial
Neumonía bacteriana (p. ej., Streptococcus pneumoniae): opacidad segmentaria típica, distribución focal, frecuente en el área inferior.
Tuberculosis pulmonar: requeriría exámenes complementarios (prueba de la tuberculina o TC) para confirmarla o descartarla.
Inflamación crónica (asma grave o síndrome de inflamación respiratoria): normalmente asociada a síntomas persistentes, no a opacidades segmentarias tan marcadas.
De un flujo de píxeles a un significado
Una webcam, por sí sola, no "ve" nada: captura un flujo de números, treinta veces por segundo, un millón de píxeles de golpe, cada uno con tres valores de color. El trabajo interesante empieza después, cuando ese flujo de números se transforma en algo que tiene significado para una persona: esto es una mano, está señalando allí; esto es un rostro, y está a punto de sonreír de verdad, no solo con la boca.
En los últimos años este paso, de píxel a significado, se ha vuelto accesible para cualquiera que tenga un portátil, gracias a un puñado de librerías de código abierto maduras que hacen el trabajo sucio (detectar un rostro, rastrear un esqueleto de mano, estimar una pose) y dejan al resto del código la tarea de decidir qué hacer con ello. En este artículo contamos el estado del arte de estas herramientas a través de tres proyectos concretos nacidos en casa: uno ya tocado en directo, uno ya en producción y uno que por ahora es solo un plan muy detallado escrito en un archivo Markdown.
Qué puede ver hoy una webcam cualquiera
Simplificando bastante, el reconocimiento visual basado en rostros/manos/cuerpos se divide en dos familias de problemas, a menudo confundidas entre sí pero conceptualmente muy distintas. La primera es la geometría: dónde están, en el espacio, los puntos que componen una mano, un rostro, un esqueleto: coordenadas, distancias, ángulos. La segunda es la semántica: qué significa esa geometría; si esta configuración de músculos faciales es una sonrisa genuina o de compromiso, si este movimiento de la muñeca es un remate o un globo. Las dos herramientas de código abierto más maduras disponibles hoy cubren, no por casualidad, exactamente estas dos familias.
MediaPipe
- 468 puntos en el rostro (Face Mesh), 21 por mano (Hands), 33 en el esqueleto (Pose)
- Modelos ligerísimos (BlazeFace/BlazePose), pensados para funcionar en tiempo real en CPU
- Funciona en el navegador mediante WebAssembly + WebGL: no hace falta ningún servidor
- Ninguna noción de "emoción" o "intención": solo coordenadas
py-feat
- Detecta Action Units faciales (intensidad por cada músculo) y emociones
- Envuelve varias redes neuronales preentrenadas (RetinaFace, modelos de regresión de AU)
- Nacido en el ámbito académico (Dartmouth) para implementar la metodología FACS
- Más pesado: pensado para funcionar en servidor, no en el navegador
Hasta hace pocos años, un pipeline decente de reconocimiento facial requería un servidor con GPU y un modelo propietario de pago. Hoy MediaPipe funciona en una pestaña del navegador del teléfono de cualquiera, y py-feat automatiza una tarea que hasta los años 2000 requería meses de entrenamiento humano especializado (lo veremos más adelante, al hablar del FACS). El salto no es solo de rendimiento: es de accesibilidad.
El theremin virtual: tocar el aire con una webcam
El primer proyecto que construimos en el "gimnasio tecnológico" de SOLVEI es un prototipo que transforma el movimiento de las manos frente a una webcam en sonido, recreando digitalmente uno de los instrumentos musicales más extraños y fascinantes jamás inventados: el theremin. Para entender por qué es un caso de estudio perfecto para hablar de reconocimiento gestual, antes hay que contar quién lo inventó: porque la historia de su inventor es, casi literalmente, más increíble que su instrumento.
Lev Termen, el hombre que tocaba el vacío
Lev Sergeevič Termen —en Occidente conocido como Léon Theremin— nace en San Petersburgo en 1896. Estudia física y, en paralelo, violonchelo: una combinación que resultará decisiva. A principios de los años 20, mientras trabaja en sensores de proximidad para medir la densidad de los gases, advierte un curioso efecto secundario: al acercar la mano a un circuito oscilante de alta frecuencia, la propia frecuencia cambia de forma audible. En lugar de considerarlo un ruido de fondo, construye sobre ello un instrumento musical.
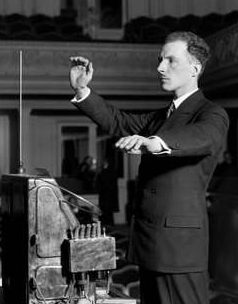
El principio es de una sencillez elegante: dos antenas, una vertical que controla la altura de la nota y otra en forma de lazo horizontal que controla el volumen, cada una conectada a un oscilador de radio. La mano del intérprete, al acercarse o alejarse, altera la capacidad eléctrica del circuito y por tanto la frecuencia generada; dos osciladores cercanos producen, por heterodinación, una frecuencia diferencia audible. El resultado se define a menudo como el instrumento musical electrónico más antiguo que aún se toca hoy, y es sin duda el primero pensado para tocarse sin ningún contacto físico: puro gesto en el espacio, captado por un campo electromagnético en lugar de un micrófono o un teclado.
Termen construye el primer theremin en Petrogrado. Se lo demuestra al mismísimo Lenin, quien, según la tradición, consigue tocar "El cisne" de Saint-Saëns a la primera y lo abraza entusiasmado.
Gira europea y luego traslado a Nueva York. La patente se cede bajo licencia a RCA. Termen funda una empresa, inventa el Terpsitone (un escenario que genera música a partir de los pasos de una bailarina) y, junto con el compositor Henry Cowell, el Rhythmicon, considerado una de las primeras cajas de ritmos de la historia.
Ahogado por las deudas de la Gran Depresión y recién casado con Lavinia Williams, bailarina afroamericana (un matrimonio ya escandaloso para la alta sociedad neoyorquina segregada de la época), Termen desaparece de un día para otro. Es reclamado — de hecho, repatriado a la fuerza — a la Unión Soviética, sin que su esposa vuelva a saber nada de él durante décadas.
Condenado a trabajos forzados, es trasladado después a una sharashka — un laboratorio-prisión del NKVD — donde se ve obligado a poner su talento al servicio del espionaje soviético. Inventa "The Thing": un micrófono pasivo oculto dentro de una reproducción en madera del escudo de EE. UU., regalada al embajador estadounidense en Moscú en 1945. Permanecerá allí, escuchando, durante siete años antes de ser descubierto. Por este trabajo recibe el Premio Stalin.
Rehabilitado durante el deshielo jruschovista, trabaja en el Conservatorio de Moscú construyendo nuevos instrumentos electrónicos, hasta que una campaña soviética contra la música "formalista" pone fin también a este capítulo.
Redescubierto por periodistas occidentales tras décadas de olvido, recibe en Moscú la visita de Robert Moog — el padre del sintetizador moderno, que de joven construía y vendía theremins — y vuelve por última vez a Estados Unidos, a los 95 años, para volver a ver a su alumna más célebre, Clara Rockmore.
Muere en Moscú, a los 97 años. Su historia — físico, músico, espía, prisionero, rehabilitado — se cuenta en el documental Theremin: An Electronic Odyssey (1993).
El theremin, en definitiva, es probablemente el primer ejemplo de reconocimiento gestual de la historia: analógico, hecho de antenas y capacidad eléctrica en lugar de redes neuronales, pero conceptualmente idéntico a lo que hacemos hoy con una webcam: transformar la posición de una mano en el espacio en un parámetro continuo, en tiempo real.
La versión digital: MediaPipe en lugar del campo electromagnético
Nuestro theremin virtual sustituye las dos antenas por MediaPipe Hands: la webcam captura el flujo de vídeo, MediaPipe extrae 21 puntos de referencia por cada mano detectada (nudillos, puntas de los dedos, palma) en cada fotograma, y a partir de esos puntos calculamos las mismas dos magnitudes que Termen obtenía con la física pura: una distancia mano-cámara que guía la altura de la nota y una segunda distancia (típicamente pulgar-índice) que guía el volumen. El principio del instrumento no ha cambiado en un siglo; solo ha cambiado la forma de capturar el gesto.
La primera versión del instrumento sonaba con un retraso perceptible y un desfase molesto entre gesto y sonido. La causa no era, como se sospechó al principio, la potencia de cálculo: era una acumulación de fotogramas en espera que crecía silenciosamente, porque nada frenaba la adquisición cuando el resto del sistema no conseguía seguir el ritmo: cada fotograma nuevo se ponía en cola aunque los anteriores aún no se hubieran procesado, y el retraso crecía con el tiempo en lugar de mantenerse constante. La solución (un "frame gate" que descarta los fotogramas sobrantes en lugar de acumularlos) es un recordatorio de que, a menudo, el cuello de botella de un pipeline de vídeo en tiempo real no es el modelo: es la cola que hay delante del modelo.
Versión actual: de prototipo a instrumento tocable de verdad
Tras la primera prueba en directo surgieron los límites típicos de todo prototipo que funciona "en teoría": un rango de algo más de seis octavas (demasiado estrecho para un piano de verdad), un gesto de cambio de forma de onda que a veces se disparaba por error y ninguna indicación visual de qué nota se estaba tocando realmente. Esto es lo que ha cambiado:
88 teclas de verdad, ya no 80
De 27,5 Hz (La0) a 4.186,01 Hz (Do8): toda la extensión de un piano acústico, ya no detenida a mitad de camino entre Mi7 y Do8. La asignación sigue siendo logarítmica: pasos iguales de movimiento de la mano cubren el mismo número de octavas, no los mismos Hz.
Dos paneles, ya no uno
Webcam y controles separados en dos columnas en lugar de una superposición semitransparente sobre el vídeo: espacio dedicado para el teclado de 88 teclas y el nombre de la nota, legibles incluso en pantalla completa.
Un puño, leído por su duración
El intento inicial de añadir un segundo gesto ("un dedo extendido") para el interruptor de entonación continua/discreta interfería con el puño existente: al volver a abrir el puño se pasa de forma natural por un estado de "un dedo extendido". Sustituido por un solo gesto, distinguido únicamente por la duración del mantenimiento: puño breve cambia la forma de onda, puño mantenido alterna entonación continua/discreta.
Nombre de la nota y teclado
En modo discreto el sonido se cuantiza al semitono más cercano (12-TET) y el nombre de la nota aparece en notación italiana (Do, Do#, Re…); el teclado de 88 teclas del panel resalta en tiempo real la tecla correspondiente.
Pinch para "congelar" la nota
Un nuevo gesto en la mano derecha (pulgar-índice, con histéresis de dos umbrales para que no parpadee): mientras se mantiene el pinch cerrado el sonido queda fijo mientras el deslizador y el teclado siguen actualizándose en vista previa, de modo que se puede recolocar la mano en silencio antes de "soltar" la nueva nota.
Se acabó el atraso de fotogramas
El retraso percibido y el tracking que "seguía por su cuenta" (manos ya fuera del encuadre, pero el backend aún ocupado en procesar fotogramas antiguos) no era un problema de potencia de cálculo sino de un mecanismo ausente que frenara el envío cuando el sistema no conseguía seguir el ritmo: un frame gate garantiza ahora como máximo un fotograma en vuelo cada vez, como ya se ha contado más arriba.
EmoLens: leer un rostro como un texto
Si el theremin virtual es un ejercicio de geometría (cuenta la posición de la mano en el espacio, no el significado del gesto), EmoLens, nuestro agente de análisis facial, se mueve íntegramente en el terreno de la semántica: no se limita a rastrear un rostro, sino que intenta entender qué está comunicando ese rostro. Para ello se apoya en una metodología que no nace en la informática, sino en la psicología experimental de hace medio siglo.
FACS: cincuenta años antes de las redes neuronales
En los años 60, el psicólogo estadounidense Paul Ekman, junto con Wallace Friesen, aborda una pregunta que parece sencilla y no lo es en absoluto: ¿cómo se mide objetivamente una expresión facial, sin que el observador proyecte sobre ella su propia interpretación cultural? Partiendo del trabajo del anatomista sueco Carl-Herman Hjortsjö, que en los años 60 ya había catalogado los músculos responsables de las expresiones faciales, Ekman y Friesen construyen en 1978 el Facial Action Coding System (FACS): una taxonomía anatómica de unas cuarenta Action Units (AU), cada una correspondiente al movimiento de un músculo o grupo muscular preciso del rostro, totalmente independiente de cualquier etiqueta emocional.
Una AU no es "una sonrisa" ni "una mueca de asco": es un movimiento muscular atómico: AU6 es la elevación de la mejilla, AU12 es la tracción de la comisura de la boca hacia arriba, AU9 es la arruga de la nariz. Las emociones reconocibles surgen solo de la combinación de varias AU. Una sonrisa genuina ("de Duchenne") es AU6+AU12 juntas; una sonrisa de compromiso es AU12 sola, sin la participación de los músculos oculares: la diferencia entre ambas, imperceptible a una mirada distraída, se vuelve medible y repetible.
La razón por la que vale la pena medirlas con esta precisión es que las expresiones no son un subproducto pasivo de la emoción: realizan un trabajo comunicativo activo: señalan a los demás cómo nos sentimos antes incluso de que encontremos las palabras, anticipan una intención (una mirada de rabia puede preceder a un enfrentamiento) y regulan en tiempo real la interacción: una sonrisa invita, un ceño fruncido pone en guardia. Y distintas emociones se concentran en zonas diferentes del rostro: la rabia y el miedo se leen sobre todo en los ojos y las cejas (contraídas y juntas en la primera, levantadas y muy abiertas en el segundo), la felicidad y el asco sobre todo en la boca y los labios, mientras que las mejillas, elevadas solo en la sonrisa genuina de Duchenne, son el detalle que más a menudo separa una emoción verdadera de una actuada.
Ekman no se detiene en la taxonomía: en esos mismos años realiza estudios de campo con la tribu fore de Papúa Nueva Guinea, aislada de todo contacto con los medios occidentales, mostrando fotografías de expresiones faciales y pidiendo que las asocien a situaciones emocionales. Los resultados respaldan la hipótesis (entonces controvertida y todavía debatida) de que un pequeño núcleo de emociones básicas se expresa con configuraciones faciales universales, las mismas en todas las culturas: felicidad, tristeza, rabia, miedo, sorpresa, asco y, propuesto más tarde por el propio Ekman y todavía debatido en la literatura, el desprecio, séptima expresión candidata a entrar en la lista.
Los estudios transculturales siguen expuestos a una objeción obvia: incluso las comunidades más aisladas tienen hoy un mínimo de contacto visual con el resto del mundo. Una prueba más nítida viene de quien nunca ha podido ver el rostro ajeno en toda su vida. En 2009 el psicólogo David Matsumoto, alumno directo de Ekman, comparó las expresiones espontáneas de atletas de judo videntes y ciegos de nacimiento en los Juegos Olímpicos y Paralímpicos de Atenas 2004, en el instante exacto de la victoria o la derrota de un combate. Las configuraciones musculares coincidían (la misma contracción de las cejas en la derrota, la misma elevación de las comisuras de la boca en la victoria), producidas por personas que nunca habían podido aprender esos movimientos mirando el rostro de otra. Si una expresión fuera un comportamiento imitado, quien nace ciego simplemente no podría reproducirla; el hecho de que la reproduzca es el argumento más sólido a favor de un origen biológico, cableado, no (solo) social.
El rostro pierde el control antes que el resto del cuerpo: una emoción verdadera, incluso cuando se quiere ocultar, deja un rastro muscular, a menudo durante una fracción de segundo, antes de que la expresión "correcta" tome el relevo. Ekman y Friesen documentan este fenómeno estudiando grabaciones de entrevistas clínicas y lo llaman microexpresión: un destello involuntario, de menos de medio segundo, que revela lo que la expresión dominante está enmascarando.
Durante décadas, codificar un vídeo con FACS fue un trabajo artesanal: convertirse en FACS coder certificado requiere unas cien horas de entrenamiento y un examen de fiabilidad, una inversión enorme para analizar pocos minutos de metraje. Es exactamente este cuello de botella el que han eliminado las herramientas modernas de código abierto.
Del FACS a EmoLens: lo que hemos construido en realidad
EmoLens se apoya en py-feat (Python Facial Expression Analysis Toolbox), un proyecto de código abierto nacido en el ámbito académico que automatiza exactamente el trabajo de un FACS coder humano: detecta el rostro (usamos RetinaFace), localiza los landmarks faciales y, con redes neuronales dedicadas, estima la intensidad de cada Action Unit y la probabilidad de cada una de las emociones básicas. Deliberadamente no activamos los modelos de identidad y mirada que ofrece py-feat: la interfaz nunca los lee, y desactivarlos reduce sensiblemente el tiempo de análisis.
El agente funciona en tres modalidades: imagen individual (análisis síncrono), webcam en directo (mediante WebSocket, con overlay dibujado en tiempo real en el frontend) y vídeo cargado o de YouTube (trabajo asíncrono). Un segundo servicio, agent-emolens-gpu, dedicado y en GPU, lleva más allá el perímetro clásico del FACS abordando exactamente el fenómeno que Ekman había documentado en los años 60: el spotting de microexpresiones, es decir, la identificación automática de las tres fases de una expresión fugaz — onset (el inicio del movimiento), apex (el pico) y offset (la disolución) — para cada Action Unit, en secuencias de vídeo de alta frecuencia de fotogramas.
Dos transparencias que vale la pena dejar por escrito. Primera: py-feat no reconoce el desprecio, la séptima emoción que parte de la literatura posterior a Ekman ha propuesto añadir a las seis originales; es un límite fijo de la librería, no nuestro. Segunda: la heurística de spotting de microexpresiones aún no está calibrada con un conjunto de datos real anotado por FACS coders humanos: funciona, está en producción con fallback automático GPU→CPU sin perder un fotograma, pero su precisión cuantitativa está todavía por validar.
Analizar rostros toca inevitablemente datos sensibles. Esto es lo que hay realmente en el código, no una lista de intenciones:
- Ninguna persistencia. Las imágenes, los fotogramas de webcam y los vídeos cargados se procesan solo en memoria o en archivos temporales y se borran inmediatamente después de su uso. No existen datos almacenados en el DBMS (Postgres) ni en el Object Store (MinIO) LOCALES utilizados a nivel de infraestructura por SOLVEIAGENTS, lo que elimina el riesgo de exfiltración de datos.
- Ninguna identificación biométrica. Los modelos de reconocimiento de identidad y de mirada (
identity_model,gaze_model) están desactivados explícitamente en la configuración. EmoLens reconoce Action Units y expresiones — cómo se mueve un rostro —, no quién es ese rostro. - Inferencia íntegramente self-hosted. Ninguna llamada a servicios cloud de terceros (OpenAI, Google Vision o similares): el análisis funciona en infraestructura propia, CPU o GPU A10 corporativa, nunca en una API externa a la que enviar un rostro.
- La estimación de la postura funciona en el navegador. El módulo PoseOverlay usa MediaPipe self-hosted mediante WASM, íntegramente del lado del cliente: para esa función ningún dato sale nunca del dispositivo del usuario.
- Acceso solo autenticado. Cada endpoint, HTTP y WebSocket, requiere inicio de sesión: doble control, a nivel de aplicación y de reverse proxy.
- Excluido de la copia de seguridad diaria, a propósito. No es un descuido: si no se conserva nada, no hay nada que guardar ni que se pueda desenterrar después.
En el plano normativo, dos puntos concretos. El AI Act (art. 5) prohíbe el reconocimiento de emociones en el lugar de trabajo y en las instituciones educativas, salvo estrechas excepciones médicas o de seguridad: un límite de uso, no de tecnología; EmoLens no está pensado para esos contextos. El RGPD (art. 9) trata como dato biométrico "especial" solo los datos tratados con el fin de identificar de forma unívoca a una persona; desactivar identity/gaze no es, por tanto, solo una elección de rendimiento, sino que mantiene el tratamiento fuera de ese umbral más estricto.
CourtIntelligence: del rostro a la pista de juego
El tercer capítulo de esta historia existe solo sobre el papel: un documento de diseño, no una línea de código funcional. Vale la pena contarlo igualmente, porque muestra bien adónde lleva de forma natural esta misma caja de herramientas cuando se apunta no a un rostro sino a una pista de juego: CourtIntelligence, un agente pensado para extraer estadísticas de un vídeo (offline, subido o por URL) de un partido de tenis playa o pádel: metros recorridos, velocidad de jugadores y pelota, recuento de golpes por tipo.
El plan, en su versión más reciente, combina herramientas que ya hemos encontrado en este artículo con otras específicas del ámbito deportivo: YOLOv8 + ByteTrack para el seguimiento multijugador, un modelo preentrenado para la pelota (el objetivo más difícil: pequeña y rapidísima), una proyección homográfica para convertir píxeles en metros reales, un filtro de Kalman causal para suavizar las trayectorias y, aquí vuelve a escena MediaPipe, la estimación de la pose, pero solo en la ventana temporal restringida alrededor de un contacto detectado, para clasificar el golpe (derecha, revés, remate, globo, dejada, volea, saque) con reglas sencillas, no con un modelo entrenado ad hoc.
Una decisión de diseño interesante del plan es que el overlay (cuadros sobre los jugadores, trayectoria de la pelota, estadísticas instantáneas) está pensado como dato estructurado dibujado sobre un canvas transparente, no "quemado" en el vídeo: el mismo componente funciona igual tanto durante el análisis en directo (datos que llegan por WebSocket mientras avanza el cálculo) como en el panel final de repetición. También el cálculo pesado está pensado para ejecutarse bajo demanda en una VM GPU dedicada, que se enciende al iniciar el análisis y se apaga sola tras un periodo de inactividad: el mismo patrón ya probado para la GPU compartida del orquestador.
CourtIntelligence nunca ha salido de la fase de diseño: ningún contenedor, ninguna línea de pipeline, ninguna migración de base de datos. El plan existe como documento de diseño detallado (nombre del agente, esquema de la base de datos, riesgos técnicos conocidos: el modelo de detección de la pelota aún no está elegido, la clasificación de los golpes no está calibrada con metraje real), listo para retomarse, no para darse por hecho.