solveiAgents funciona sobre dos VM de Oracle Cloud: un ARM64 siempre encendido que aloja el orquestador, los agentes y tres aplicaciones verticales en producción (MediLog, Survey, Legal), y una GPU NVIDIA A10 privada, sin IP pública, que se enciende solo bajo demanda mediante IAM Instance Principal y se apaga sola. Solo cuatro servicios gestionados de OCI intervienen realmente (IAM, VCN, Compute, Work Requests API); todo lo demás — reverse proxy, almacenamiento, observabilidad, copias de seguridad — es software de código abierto en contenedores, gestionado por cuenta propia.
Dos máquinas, dos tareas distintas
Toda la plataforma solveiAgents —el orquestador, catorce agentes especializados y, por encima de ellos, tres aplicaciones verticales ya en producción (MediLog, Survey, Legal)— funciona sobre dos máquinas virtuales de Oracle Cloud Infrastructure (OCI), no una. La división no es estética: refleja dos necesidades opuestas.
El primer VPS es una instancia de Compute Ampere ARM64 con 24 GB de RAM, en una subred pública de la VCN, siempre encendida. Aloja todo lo que debe poder responder en cualquier momento: el reverse proxy, el orquestador, las bases de datos y la mayoría de los agentes (arrancados y detenidos bajo demanda por un watcher de inactividad, pero sobre el contenedor host que los aloja, que nunca duerme). El segundo es una GPU NVIDIA A10, en una subred privada sin ninguna dirección pública, que se enciende solo cuando de verdad se necesita la potencia de cálculo que el ARM64 no tiene.
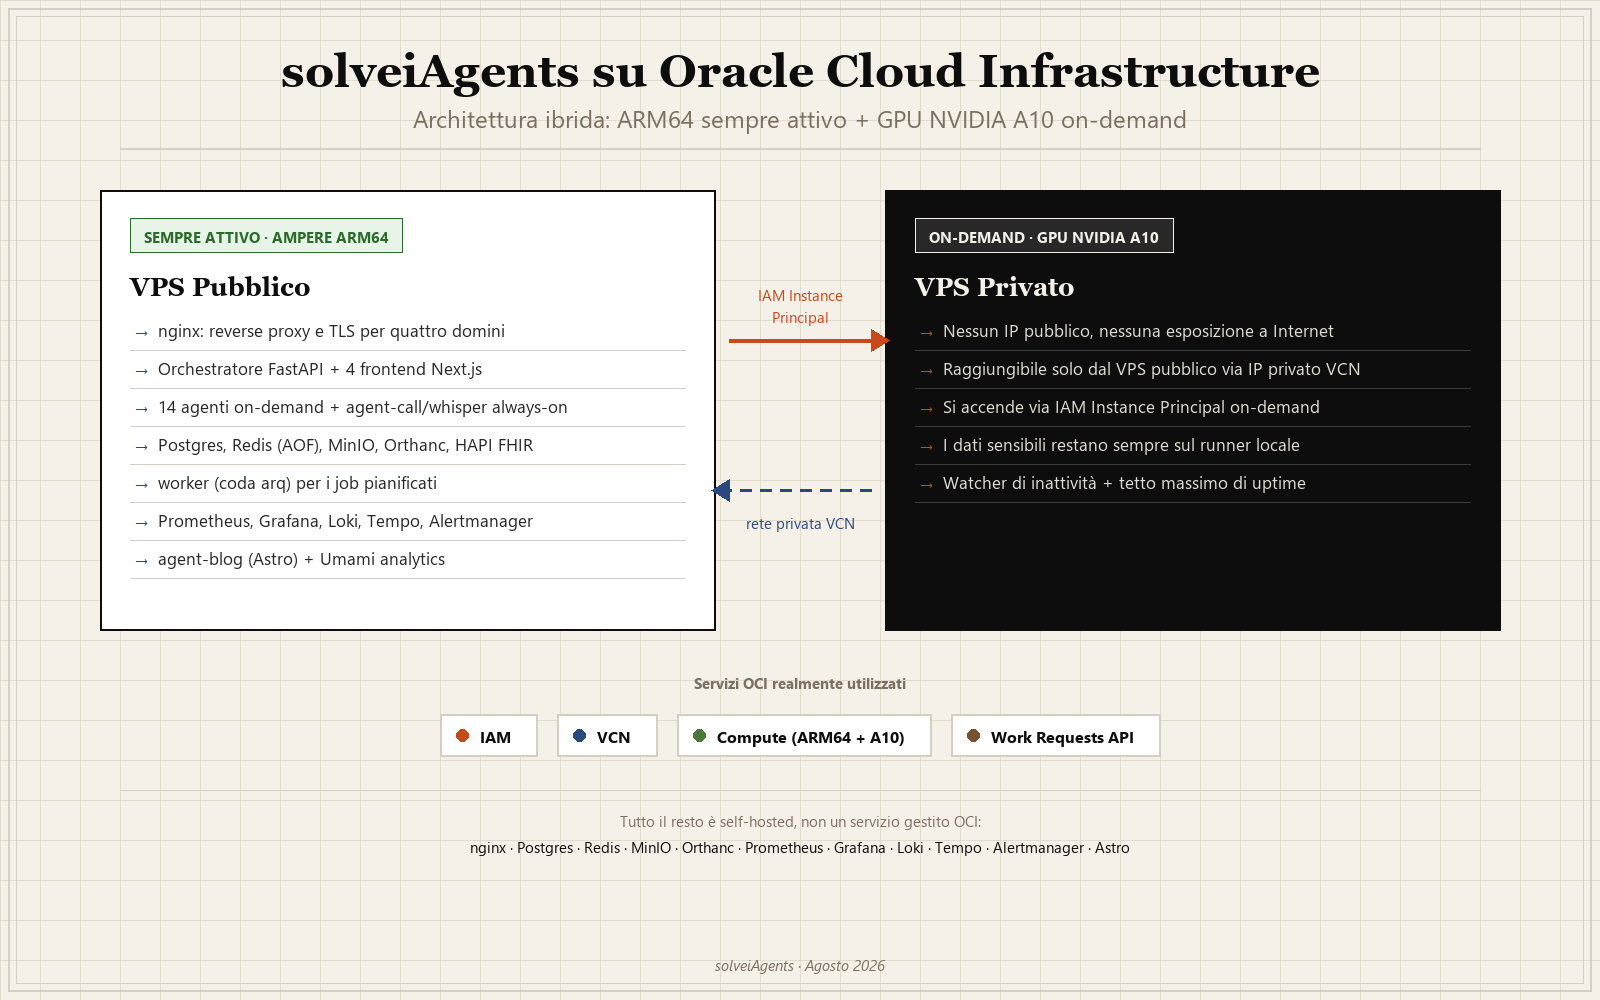
Así se reparten las tareas en la práctica, al detalle:
VPS público
- nginx: reverse proxy y TLS para cuatro dominios (agents/medilog/survey.solvei.it + legal.solvei.it detrás de Nginx Proxy Manager)
- Orquestador FastAPI + cuatro frontends Next.js (plataforma, MediLog, Survey, Legal)
- Catorce agentes bajo demanda + agent-call y agent-whisper, siempre activos para videollamadas y transcripciones
- Postgres, Redis (con persistencia AOF), MinIO, Orthanc, HAPI FHIR
- worker (cola arq) para los trabajos planificados
- Prometheus, Grafana, Loki, Tempo, Alertmanager
- agent-blog (sitio estático Astro) y Umami para la analítica
VPS privado
- Sin dirección IP pública, sin exposición directa a Internet
- Accesible solo desde el VPS público, mediante la IP privada de la VCN
- Se enciende mediante IAM Instance Principal cuando un agente solicita inferencia pesada
- Los datos sensibles se quedan siempre en el runner LLM Ollama local
- Un watcher de inactividad la detiene sola; un tope máximo de uptime la detiene de todos modos en pocas horas
Qué ocurre cuando un agente necesita la GPU
Ningún agente habla directamente con las API de OCI. Cuando una tarea requiere un modelo que no funciona cómodamente en el ARM64, llama al gpu_manager o al servicio equivalente del orquestador, usado para el arranque y la parada independientes del widget de GPU de los frontends. Ambos se autentican en OCI con una Instance Principal: ninguna clave de API guardada en algún sitio; la propia identidad de la VM pública, autorizada por un Dynamic Group y una política IAM dedicada, es la credencial.
Una vez terminada la tarea, la GPU no se queda encendida "por si acaso": un watcher de inactividad la detiene solo tras un periodo configurable. Y si incluso ese mecanismo fallara (un reinicio del agente que pone a cero un temporizador en memoria, un bug aún no descubierto), un segundo control independiente, un tope máximo de uptime (por defecto cuatro horas), la apaga de todos modos.
La GPU privada se parece más a un generador de emergencia que a un servidor: está apagada la mayor parte del tiempo, se enciende sola cuando la carga normal no basta y se vuelve a apagar sin que nadie tenga que acordarse, ni pagar la factura.
Qué hace realmente OCI (y qué no)
Vale la pena ser precisos, porque es fácil imaginar una infraestructura cloud como un paquete de servicios gestionados (almacenamiento de objetos, API gateway, monitorización nativa) cuando en realidad la mayor parte de lo que funciona en estas dos máquinas no es un servicio de OCI: es software de código abierto en contenedores gestionado por nosotros. Los servicios de OCI que intervienen realmente son solo cuatro:
El reverse proxy es un nginx en contenedor, no un Load Balancer de OCI: un único contenedor termina el TLS de cuatro dominios y enruta por ruta. El almacenamiento de objetos es MinIO self-hosted, compatible con S3, no OCI Object Storage. El blog es un sitio estático Astro regenerado por un agente dedicado. Y toda la pila de observabilidad, de la que hablamos enseguida, es Prometheus, Grafana, Loki, Tempo y Alertmanager en contenedores, no el Cloud Monitoring nativo de OCI.
El motivo es sencillo: una instancia ARM64 Ampere basta para ejecutar todo esto cómodamente, y mantener la pila de código abierto nos deja el control total sobre unos datos que, en el caso de los agentes que tratan información sanitaria o jurídica, no deben salir nunca de nuestra infraestructura.
Por qué la GPU no tiene una dirección pública
La subred privada no es un detalle de implementación: es la decisión de diseño que hace aceptable mantener encendida, aunque solo sea unos minutos, una máquina con un modelo LLM que procesa peticiones reales. No hay ningún puerto publicado hacia Internet en el VPS de la GPU; la única forma de alcanzarlo es pasar por el VPS público, mediante la IP privada de la VCN, y solo con las credenciales IAM adecuadas.
La misma disciplina vale para la autenticación de usuarios: Clerk, el proveedor de identidad que usan todos los frontends, funciona en modo production, con la verificación de los JWT centralizada en un único módulo compartido que consumen cinco servicios distintos.
Logs, trazas y métricas: saber qué pasa antes de que sea un problema
Logs centralizados
Cada agente, no solo los tres o cuatro "principales", escribe sus propios logs en Loki mediante un módulo compartido.
Trazas distribuidas
OpenTelemetry, con exportación a Tempo, está ahora activo en quince agentes: cada petición lleva consigo un traceparent propagado desde el orquestador hasta el interior del agente que la atiende, de modo que una petición lenta se puede seguir de extremo a extremo en lugar de tener que cruzar los logs a mano servicio por servicio.
Métricas y alertas
Prometheus "observa" a cada agente activo; dos métricas pensadas expresamente para la supervisión, agent_restarts_total y agent_up, alimentan una regla de alerta dedicada (AgentFlapping, un agente que se reinicia más de tres veces en diez minutos) junto a la ya existente sobre el circuit breaker abierto durante demasiado tiempo. Alertmanager cierra el círculo: antes las reglas "saltaban" solo visualmente dentro de Prometheus, sin avisar a nadie.
Los informes operativos
En concreto, quien opera la plataforma mira dos sitios. El panel de Grafana Solvei Agents Overview, autoaprovisionado, con throughput, latencia p50/p95 y tasa de error por servicio. Y el panel /monitoring del frontend, con tres secciones: LiveSection muestra las peticiones en curso en tiempo real (estado "en clasificación" → "en streaming" → "completada", o "abandonada" si el cliente se desconectó a mitad); LogViewer consulta Loki por servicio, nivel y periodo sin salir del navegador; DeployPanel ejecuta git pull, build, restart y reload de nginx en streaming, directamente desde la UI.
Copias de seguridad y recuperación ante desastres
Una copia pg_dump diaria cubre todo el Postgres, esquema por esquema: plataforma, historia clínica MediLog, datos FHIR, Survey, Legal, Umami. Junto a ella, tar de solo lectura para los datos binarios que no viven en la base de datos: MinIO, Orthanc (estudios DICOM), los cuestionarios en papel cargados, las wikis generadas, los posts del blog, los datos de Open WebUI. Un destino rsync offsite está disponible como opción, no activada por defecto. Un runbook (scripts/restore.sh) guía la restauración paso a paso, por componente y no todo a la vez, con un modo dry-run por defecto que imprime los comandos antes de ejecutarlos de verdad.
El trabajo de copia de seguridad se ejecuta en la cola de trabajos planificados (el párrafo siguiente), ya no como llamada directa dentro del proceso del orquestador: si la cola no responde, la vieja ruta directa sigue ahí como red de seguridad; en el caso de la copia de seguridad, el riesgo de que "no lo haya ejecutado nadie" pesa más que el de saltarse la cola de vez en cuando.
Quién lo mantiene todo en pie cuando nadie mira
Un puñado de mecanismos, todos independientes entre sí, se ocupan de mantener coherente la plataforma sin intervención manual:
Tres aplicaciones verticales, una sola plataforma
Todo lo descrito hasta ahora no es un ejercicio de infraestructura porque sí: es la base sobre la que funcionan tres productos verticales reales, que comparten el mismo orquestador, el mismo Postgres, la misma autenticación Clerk y la misma pila de observabilidad.
Historia clínica digital (PHR) — a partir de los datos demográficos y de los eventos clínicos, ha crecido hasta FHIR R4, OCR con extracción automática de los valores de laboratorio, gestión de DICOM con visor OHIF, videollamadas paciente-médico mediante mediasoup y perfiles familiares compartidos.
Digitalización de cuestionarios en papel — pipeline híbrido OMR (reconocimiento óptico de marcas) más un modelo de visión para los casos dudosos, cola de validación humana, paneles estadísticos.
Plataforma jurídica de IA — fork de un proyecto de código abierto, integrada con 214 herramientas jurídicas italianas mediante el protocolo MCP (Normattiva, Casación, TJUE, cálculos de intereses y honorarios, más de cien modelos de documentos).
Ninguna de las tres ha requerido una nueva infraestructura desde cero: engancharse significa registrar un nuevo agente en el registro existente, añadir un esquema al Postgres compartido y beneficiarse gratis de todo lo que este artículo ha descrito, incluidos logging, tracing, copias de seguridad y watchdogs. Es probablemente la prueba más concreta de que la arquitectura de dos VPS no solo es sensata económicamente, sino que además permite añadir un producto vertical en semanas, no en meses.
No hace falta una nube enorme, hace falta una nube honesta
El valor de esta arquitectura no está en el número de servicios gestionados de OCI que usa (son deliberadamente pocos) sino en la claridad con que separa "siempre encendido" de "bajo demanda" y en el trabajo que mantiene coherentes las dos mitades: un log que llega siempre a Loki, una traza que atraviesa todos los servicios, una copia de seguridad que arranca incluso si la cola que debería lanzarla no responde, un agente que se apaga solo incluso cuando alguien lo encendió a mano por error.
Esta infraestructura se concibió como "gimnasio tecnológico personal", pero adoptando buenas prácticas derivadas de más de 35 años de experiencia sobre el terreno 🙂 y podría ser una buena base para implementar proyectos distintos. Los datos sensibles no salen nunca de la infraestructura y usan solo servicios locales. En cualquier caso, para reducir la hipotética superficie de ataque, los servicios expuestos a internet pueden activarse o desactivarse mediante Nginx Proxy Manager (código abierto).
Probablemente, para reforzar aún más la privacidad, mi próximo paso será implementar un servicio privado de correo electrónico y mensajería basado en soluciones de código abierto... diría que ya es hora de dejar de compartir información privada con las big tech 🙂.
Espero que este artículo te haya resultado útil si estás evaluando una arquitectura similar para tus proyectos.